Python 3 и ajax запросы
1. Request URL:
http://198.xx.xx.xx:xxxx/sport/tracks/index.m3u8?xxxxxx=xxxxxxxxx
2. Request Method:
GET
3. Status Code:
200 OK
4. Remote Address:
198.xx.xx.xx:xxxx
5. Referrer Policy:
no-referrer-when-downgrade
Какими средствами можно это получить ? Модуль Reguests не рендерит ajax запросы, насколько я понял.
Alecsandr1980
15.04.19 17:08:55 MSK
url = scheme + host:port + path + searchQuery
ищи эти части, склеивай
bvn13 ★★★★★
( 15.04.19 18:55:38 MSK )
Ответ на: комментарий от bvn13 15.04.19 18:55:38 MSK
Подскажите с помощью чего это можно узнать, какими модулями нужно пользоваться и тд.?
Alecsandr1980
( 15.04.19 19:33:01 MSK ) автор топика
selenium в помощь, парсеры не умеют в яваскрипт, но ресурса он жрет просто до.
qshiroe
( 15.04.19 21:52:12 MSK )
Ответ на: комментарий от qshiroe 15.04.19 21:52:12 MSK
Вот я о нем и подумал, поначалу. Но потом понял что вообще не получается вывести заголовки ответов как к примеру это делается в REGUESTS. В selenium я еще не разобрался, возможно мой косяк. Читал о SCRAPY но не понял может он это или нет. Selenium это точно может?
Alecsandr1980
( 15.04.19 22:37:23 MSK ) автор топика
Ответ на: комментарий от bvn13 15.04.19 18:55:38 MSK
Ты лингвист, гадалка или психотерапевт? Читая поток мыслей таких товарищей, лучшее, что я могу сделать — ничего не отвечать.
Наугад чтоли отвечаешь?
WitcherGeralt ★★
( 16.04.19 00:24:19 MSK )
anonymous
( 16.04.19 02:39:35 MSK )
Ответ на: комментарий от anonymous 16.04.19 02:39:35 MSK
Alecsandr1980
( 16.04.19 10:27:18 MSK ) автор топика
Ответ на: комментарий от WitcherGeralt 16.04.19 00:24:19 MSK
Ответ на: комментарий от bvn13 15 апр. 2019 г., 18:55:38
Ты лингвист, гадалка или психотерапевт? Читая поток мыслей >таких товарищей, лучшее, что я могу сделать — ничего не >отвечать.
Наугад чтоли отвечаешь?
Странный вы человек. Если не хотите отвечать, зачем писали, следили за темой. А если я что-то непонятно написал, можно было и уточнить.
Alecsandr1980
( 16.04.19 10:33:33 MSK ) автор топика
Ответ на: комментарий от Alecsandr1980 16.04.19 10:33:33 MSK
Ни за чем я не следил, что за глупости ты выдумываешь. А написал я непосредственно bvn13.
Я бы уточнил, будь топик хоть сколько-то внятным, а так, это бесполезно.
WitcherGeralt ★★
( 16.04.19 10:40:30 MSK )
Ответ на: комментарий от WitcherGeralt 16.04.19 10:40:30 MSK
Раз так пошло, объясни что невнятно? Я как мог объяснил все в своем вопросе с примером вывода информации в браузере (Chrome).
В теме о парсинге ajax запросов я новичок. До этого, в предыдущих задачах мне хватало модулей reguests,bs,json все что нужно забирал с помощью них. Сейчас стало интересно разобраться как забирать ссылки созданные ajax которые отображаются при исследовании страницы в разделе «Сеть». Что невнятно?
url = scheme + host:port + path + searchQuery
ищи эти части, склеивай
bvn13, спасибо. Он все правильно написал.
И да,я не программист, я видеооператор. Изучаю эту тему для себя, для общего развития.
Alecsandr1980
( 16.04.19 11:13:47 MSK ) автор топика
Ответ на: комментарий от Alecsandr1980 16.04.19 11:13:47 MSK
Для начала, в природе не существует такой сущности как «ajax-запрос», это устаревший термин, которым обозначали обычные http-запросы из JavaScript (Asynchronous Javascript and XML), когда эта концепция была ещё вновинку. Т.е. «ajax-запрос» нельзя парсить и уж тем более «рендерить», особенно питоном. Ты имел ввиду просто форматированный вывод урла и заголовков?
Вот тебе ответ по первой же ссылке на запрос «python requests print request»:
import requests import httplib def patch_send(): old_send= httplib.HTTPConnection.send def new_send( self, data ): print data return old_send(self, data) #return is not necessary, but never hurts, in case the library is changed httplib.HTTPConnection.send= new_send patch_send() requests.get("http://www.python.org") Без обид, но это настолько невменяемо, что ты даже сам не понял чего хочешь и не смог погуглить.
WitcherGeralt ★★
( 16.04.19 12:29:22 MSK )
Последнее исправление: WitcherGeralt 16.04.19 12:30:00 MSK (всего исправлений: 1)
Ответ на: комментарий от WitcherGeralt 16.04.19 12:29:22 MSK
Спасибо, что ответили.
Для начала, в природе не существует такой сущности как «ajax-запрос»
Согласен, меня уже правили, но как назвать не знал поэтому выбрал это название (ajax). Прекрасно понимаю, что все это язык js (ajax это Javascript and XML). На сайте который я исследую уйма скриптов и jQwery и многое другое и кто конкретно с чем взаимодействует для меня загадка. Был контент в js который удалось прочитать используя модуль «base64». Сам «JS» знаю плохо (поверхностно, азы, без фреймворков и пр.), но планирую изучать.
Т.е. «ajax-запрос» нельзя парсить и уж тем более «рендерить», особенно питоном.
Пока изучаю питон, поэтому смотрю, что можно сделать на питоне. Слово «Рендер» и сочетании «рендер страницы» фигурируют в сети очень часть. Вбив в поиске «рендер страницы» можно увидеть в первой ссылке:
https://habr.com/ru/post/224187/
26 мая 2014 в 20:08
Рендеринг WEB-страницы: что об этом должен знать front-end разработчик
Интернет кишит этим, и я и другие начинающие это читаем. Поэтому так и пишем.
Ты имел ввиду просто форматированный вывод урла и заголовков?
Возможно это так называется, я не знаю этого. Но ссылки которые вижу в исследовании отсутствуют в html коде страницы. Открывал файлы скриптов исследуя, но тоже в чистом виде не увидел (защита от таких как я и пр.). А логику понять пока не могу. Не знаю много еще чего.
Вот тебе ответ по первой же ссылке на запрос «python requests print request»:
Спасибо за ссылку! Но этот код для python2, а я писал в заголовке что мне нужно решение для python3. В python3 данная библиотека httplib переименована » You are running Python 2 code on Python 3. In Python 3, the module has been renamed to http.client». В любом случае огромное спасибо буду пробовать.
Без обид, но это настолько невменяемо, что ты даже сам не понял чего хочешь и не смог погуглить.
На вас обиды нет, жаль что думаете, что не искал, искал и долго и много. Но внятного и понятного мне не обнаружил. Запросы вводил разные: «python3 xhr», «python3 requests xhr», «python3 requests xhr», «python3 запрос заголовков», «python3 URL запроса», «python3 URL ajax» и многое другое .
Вообщем сечас имею то что имею.
url = scheme + host:port + path + searchQuery
ищи эти части, склеивай
Смысл верный, как-то так и есть, но как это все найти и получить? До этого пытался сам похожим путем идти, искать фрагменты строк и соединять.
Заинтересовало, на сейчас все установил,пытаюсь вникнуть как работает и что могу узнать.
Вот тебе ответ по первой же ссылке на запрос «python requests print request»:
import requests
import httplib
.
Нужно разбираться с библиотекой http.client или httplib2.
Alecsandr1980
( 16.04.19 14:17:04 MSK ) автор топика
Ответ на: комментарий от Alecsandr1980 16.04.19 14:17:04 MSK
Ну, да, я уже после того как запостил, осознал, что нужен был именно третий. В любом случае, он до сих пор во многих дистрах основной, а направление в целом верно и для третьего. Там были и другие ответы, разумеется, ибо первым в выдаче по таким вопросам почти всегда будет stack oveflow.
Парсинг AJAX в BeautifulSoup Python?
Решил попробовать реализовать парсер вакансий. Сайт выдает только 20 ссылок, дальше кнопка «Больше».
Через вкладку «Network» посмотрел что отправляет запрос. Костыльно вытащил CSRF_TOKEN (вытаскивает раз через раз) и сделал запрос, получаю статус-код 403.
import requests from bs4 import BeautifulSoup HEADERS = URL = "https://jobs.dou.ua/vacancies/?category=Ruby" session = requests.Session() def get_html(url): r = session.get(url, headers=HEADERS) return r def get_links(response): if response.status_code == 200: html = BeautifulSoup(response.text, "html.parser") lis = html.find_all('li', class_="l-vacancy") # Количество вакансий до нажатия print(len(lis)) # Костыльно достаю csrf script = str(html.select('script')[5]) csrf = str(script[32:32+64]) print(script) print(csrf) load_data = < 'csrfmiddlewaretoken': csrf, 'count': 20>response = session.post('https://jobs.dou.ua/vacancies/xhr-load/?category=Ruby', data=load_data) print(response.status_code) html = BeautifulSoup(response.text, "html.parser") lis = html.find_all('li', class_="l-vacancy") # Количество вакансий после нажатия print(len(lis)) else: return 'Connection error!' get_links(get_html(URL))- Вопрос задан более трёх лет назад
- 1315 просмотров
Комментировать
Решения вопроса 1

Сайт заблокирован в РФ, но напишу общие рекомендации, должно работать
- Интересно, вы, конечно получаете токен. Он в JSON формате я так понимаю? Подключите библиотеку json и сделайте json.loads(script). Оттуда уже достаньте токен, как из обычного словаря. Так же не верю что скрипт там без аттрибутов, лучше по классу/id/итд получить его
- XHR запрос не выглядит полным. Там случайно нет еще каких нибудь параметров?
- В XHR заголовки добавьте
- Может не обойтись одним user-agent, попробуйте добавить другие, посмотрите какие там есть, может какие нибудь необычные присутствую. Можно попробовать добавить Accept/Referrer и другие.
Ответ написан более трёх лет назад
bfesiuk @bfesiuk Автор вопроса
Здраствуйте, спасибо за помощь)
Немножко обновил скрипт:
import requests from bs4 import BeautifulSoup import json HEADERS = URL = "https://jobs.dou.ua/vacancies/?category=Ruby" session = requests.Session() def get_html(url): r = session.get(url, headers=HEADERS) return r def get_links(response): if response.status_code == 200: html = BeautifulSoup(response.text, "html.parser") lis = html.find_all('li', class_="l-vacancy") # Количество вакансий до нажатия print(len(lis)) # Костыльно достаю csrf script = str(html.select('script')[5]) csrf = str(script[32:32+64]) print(script) print(csrf) load_data = < 'csrfmiddlewaretoken': csrf, 'count': 20>response = session.post('https://jobs.dou.ua/vacancies/xhr-load/?category=Ruby', data=load_data) html = BeautifulSoup(response.text, "html.parser") lis = html.find_all('li', class_="l-vacancy") # Количество вакансий после нажатия print(len(lis)) else: return 'Connection error!' get_links(get_html(URL))Ответ получаю либо такой:
Количество вакансий до нажатия: 20
script:
csrf: ild/built.v2069.75176dd.js» type=»text/javascript»>
Количество вакансий после нажатия: 0
Количество вакансий до нажатия: 20
script:
csrf: FDWmjTJdOi1CHjjIcUbjobYCNr0DFBqMB98TZ0jcCCxHYvejjlWjGPmwlHDQOKoz
Количество вакансий после нажатия: 0
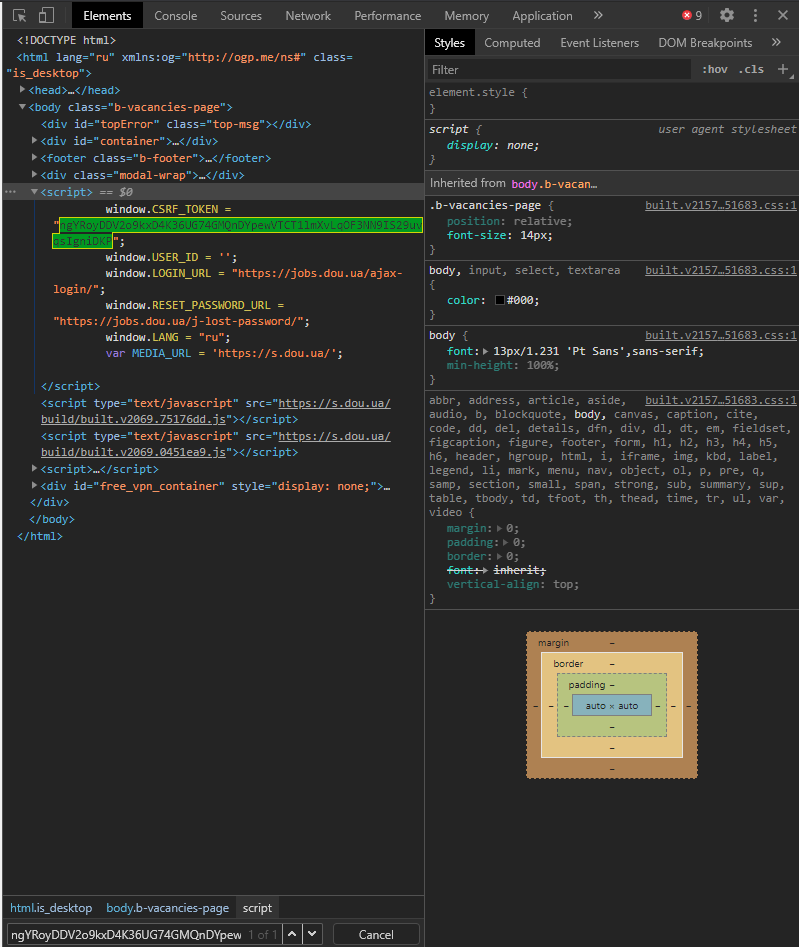
Тег скрипта выгладит таким образом (класса или айди найти не удалось) возможно есть еще какие нибудь пути достать корректно:

Сам XHR запрос выглядит так:
Скорее всего я что-то упустил.
Спасибо за отклик)
Парсинг Ajax. Python + Requests
Всем привет. Занимаюсь парсингом одного сайта, один из параметров — номер телефона владельца, но он изначально скрыт и подгружается с помощью ajax’а. При нажатии на кнопку «показать телефон» во вкладке Network в разделе Response пишет только «OK». При составлении post запроса такой же ответ. Вопрос: Какими способами можно достать номер телефона, используя: python + requests
Отслеживать
задан 13 июн 2017 в 6:56
Александр Курмазов Александр Курмазов
426 1 1 золотой знак 6 6 серебряных знаков 15 15 бронзовых знаков
Случаем не авито? 😀
13 июн 2017 в 6:59
@gil9red Не авито, но похожий сайт.
13 июн 2017 в 7:00
Если через ajax не приходит, ищите номер в предыдущих запросах. Возможно, он на самой странице находится, но закодирован. Когда занимался парсингом сайтов-объявлений, я на каком-то сайте увидел номер телефона в base64, а тот после клика просто декодировался и показывался.
13 июн 2017 в 7:01
Кст, если хотите получить таки точный ответ на ваш вопрос, лучше ссылку предоставить 🙂
13 июн 2017 в 7:22
@gil9red realestate.ru/flatrent/4274613 пожалуйста)
13 июн 2017 в 7:23
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
Готово, ниже этого кода я напишу подробнее, что тут происходит:
import math import requests from bs4 import BeautifulSoup def decrypt_phone(clipped_phone, value): decrypt = value / 17 p1 = int(math.floor(decrypt / 100)) p2 = int(decrypt - 100 * p1) t1 = str(p1)[1:] + '-' + str(p2).zfill(2) return clipped_phone.replace(". ", "") + t1 def get_phone(url): rs = requests.get(url) root = BeautifulSoup(rs.content, 'lxml') button_show_phone = root.select_one('#show-phone_button') blst = int(button_show_phone['blst']) lst1 = int(button_show_phone['lst1']) lst2 = int(button_show_phone['lst2']) phones = [] for phone_tag in root.select('.object-builder-phone'): if phone_tag.has_attr('blst') and phone_tag['blst'] == 'true': value = blst elif phone_tag.has_attr('lst1') and phone_tag['lst1'] == 'true': value = lst1 elif phone_tag.has_attr('lst2') and phone_tag['lst2'] == 'true': value = lst2 else: raise Exception('Отсутствует один из атрибутов: blst, lst1, lst2, или значение не "true"') phone = decrypt_phone(phone_tag.text, value) phones.append(phone) return phones print(get_phone('http://www.realestate.ru/flatrent/4274613/')) print(get_phone('http://www.realestate.ru/retailrent/176651/')) print(get_phone('http://www.realestate.ru/retailrent/180232/')) ['+7 495 626-84-44'] ['+7 964 718-31-13'] ['+7 926 777-01-75', '+7 926 777-01-84'] Телефон и вправду был на странице, но закодирован. У кнопки показать телефон ( #show-phone_button ) есть волшебные атрибуты blst , lst1 и lst2 . Один из атрибутов хранит оставшиеся 4 цифры телефона, скрытые от любопытных глаз.
То, какой атрибут использовать зависит от тега с обрезанным номером телефона ( .object-builder-phone ). В теге есть один атрибутов blst , lst1 и lst2 с значением «true» .
Сам скрипт, в котором обрабатывает клик на кнопку показать телефон, декодировка номера и замена, называется shared.js (см. рисунок).
shared.js я нашел случайно – просто тыкал и смотрел скрипты, т.к. поиск по show-phone_button ничего не дал, даже когда открыл тот скрипт
А вот так выглядит функция декодирования (я ее переписал как decrypt_phone ):
function ShowAttr(e, attr, value) < if ($(e).attr(attr) == "true") < var decrypt = value / 17; var p1 = Math.floor(decrypt / 100); var p2 = decrypt - 100 * p1; var t1 = ("" + p1).substring(1) + '-' + pad(p2, 2); $(e).text($(e).text().replace(". ", "") + t1); $(e).attr(attr, 'false'); >> Как получить доступ к Ajax контенту во время парсинга?
В общем случае, при помощи парсинга html, не возможно получить страницу в том виде в который ее приводят ее собственные джаваскрипты при загрузке потому, что парсер — не браузер, он не исполняет джаваскрипты.
В частных случаях можно вынуть из текста скрипта все urlы по которым идут ajax запросы, производить все эти запросы в своем коде и парсить результаты. Тут куча подводных камней — во-первых, параметры ajax запроса могут быть спрятаны в коде каким-нибудь не тривиальным образом, во-вторых нужно правильно выставить все заголовки запроса со всеми куками (которыми скрипты со страницы так же могут манипулировать), потом не забыть правильно задать referrer. В общем случае у скриптов на странице всегда остается возможность, используя какие-нибудь динамически меняющиеся параметры, запутать свою работу так, что для такой страницы создать парсер будет невозможно.
Радикально иной вариант — использовать настоящий браузер (через Sillentium, например), который исполняет все скрипты и, с точки зрения противоположной стороны, неотличим от живого пользователя. Это решает все проблемы с хитрыми ajax-ами. Но это уже совсем другой порядок объемов потребляемых ресурсов и скорости. Если, например, на самом дешевом vps (с 128 Мб памяти) на гигабитном канале можно парсить в 50-100 потоков. Даже из расчета по несколько секунд на ожидание + обработку каждой страницы получаем 10-20 расперсенных страниц в секнду. Теперь если перейти на Sillentium + Webkit, то 128 Мб уже не хватает для запуска даже одного потока. Если даже запускать все это на своем домашнем десктопе с гигабайтами памяти (с vps в качестве прокси), то можно получить максимум несколько расперсенных страниц в секунду. То есть парсинг через полноценный браузер не конкурент парсерам типа lxml + requests/liburl.
Ответ написан более трёх лет назад
Комментировать
Нравится 2 Комментировать
Ответы на вопрос 1

Берете браузер, открываете инструмент разработчика(F12 обычно), вкладка Networking, ставите фильтр на XHR запросы, обновляете страницу, если нужно куда-то нажать, чтобы выполнился Ajax — нажимаете. Все что нужно должно отобразиться на панели запросов, также там есть вся нужная информация по запросу(заголовки, параметры, ответ), изучаете апи и сами делаете такие же запросы из питона.