Найти количество слов в строке

Найти количество слов в строке
Добрый день! Есть задача написать функцию, которая принимает в качестве аргумента строку и.
Найти количество слов, содержащихся в данной строке
Описать процедуру SplitStr(S, W, N), которая формирует по данной строке S массив W слов, входящих.
Найти количество слов в строке и вывести результат в словаре
Здраствуйте. Практикуюсь на одном сайте с задачами. Не могу решить одну из них. Прошёл дальше её.
Дана строка,содержащая английский текст. Найти количество слов в этой строке,начинающихся с буквы b.
Дана строка,содержащая английский текст. Найти количество слов в этой строке,начинающихся с буквы.
Найти количество слов содержащих только символы латинского алфавита, а среди них количество слов с гл. и согл
Найти количество слов содержащих только символы латинского алфавита, а среди них количество слов с.
4459 / 3212 / 1125
Регистрация: 21.03.2016
Сообщений: 7,949
print(len(input().split()))
вам же нужно количество слов, обычно знаки пишутся с словом слитно а потом идет пробел между словами, думаю заменять знаки смысла нет

5416 / 3840 / 1214
Регистрация: 28.10.2013
Сообщений: 9,554
Записей в блоге: 1
 Сообщение от KiritoSan

«Очень продуманный»
Серьезно? Бесполезнее варианта я еще не видел.
Кол-во слов в строке, во-первых, зависит от определения того, что мы понимаем под «словом» (это могут быть десятки самых разных вариантов), а во-вторых, в простейшем случае достаточно поделить текст по пробельным символам и подсчитать сколько там всего токенов получилось.
Это ровно одна строка кода.
Добавлено через 41 секунду
P.S. Ну вот Semen-Semenich, подтвердил — ровно одна строка кода.
Регистрация: 26.03.2019
Сообщений: 35
Проверьте на строке ‘привет , мир !’
5416 / 3840 / 1214
Регистрация: 28.10.2013
Сообщений: 9,554
Записей в блоге: 1
1 2 3
>>> re.findall(r'\b\w+\b','привет , мир !') ['привет', 'мир'] >>>
1 2 3 4 5
>>> import string >>> [w for w in 'привет , мир !'.split() if w not in string.punctuation] ['привет', 'мир'] >>>
4459 / 3212 / 1125
Регистрация: 21.03.2016
Сообщений: 7,949
1 2 3 4 5
def fun_isalpha(data): return bool(list(filter(lambda x : x.isalpha(),data))) data = 'привет , мир !' print(sum(fun_isalpha(x) for x in data.split()))
Регистрация: 26.03.2019
Сообщений: 35
Semen-Semenich, спасибо, но код всё равно не проходит все тесты. Только теперь не 6, а 4.
178 / 147 / 21
Регистрация: 07.11.2009
Сообщений: 591
KiritoSan, нужно понимание что подразумевается под словом. Предлоги, союзы и прочее являются ли словами в твоем задании? Если нет, ограничь длинной в 4-е символа например.
1040 / 575 / 242
Регистрация: 15.01.2019
Сообщений: 2,178
Записей в блоге: 1
Сообщение от KiritoSan
Semen-Semenich, спасибо, но код всё равно не проходит все тесты. Только теперь не 6, а 4.
Какой же бред эти ваши курсы с тестами, которые не показывают, какие тесты неверны. Как вы этого не понимаете, хоспади?
Добавлено через 2 минуты
Сообщение от leery_user
KiritoSan, нужно понимание что подразумевается под словом. Предлоги, союзы и прочее являются ли словами в твоем задании? Если нет, ограничь длинной в 4-е символа например.
какая глупость. это всё является словами.
тут разве что привязка к регистру и к знакам может быть.
4459 / 3212 / 1125
Регистрация: 21.03.2016
Сообщений: 7,949
KiritoSan, полное условие задачи скопируйте. может там есть что то о чем мы не знаем и ссылку на страницу задания
Регистрация: 26.03.2019
Сообщений: 35
На вход программы поступает строка текста, в которой могут встречаться:
— прописные и строчные (т.е. большие и маленькие) латинские буквы;
— пробелы;
— знаки препинания: точка, запятая, восклицательный и вопросительный знак;
— символ –, обозначающий в некоторых случаях тире, а в некоторых — дефис.
Слово — это последовательность подряд идущих латинских букв и знаков дефис, ограниченная с обоих концов. В качестве ограничителей могут выступать начало строки, конец строки, пробел, знак препинания, тире. Тире отличается от дефиса тем, что слева и справа от знака дефис пишутся буквы, а хотя бы с одной стороны от тире идет либо начало строки, либо конец строки, либо пробел, либо какой-либо знак препинания, либо еще одно тире.
Напишите программу, определяющую, сколько слов в данной строке текста.
Входные данные
Вводится строка длиной не более 200 символов.
Выходные данные
Выведите одно число — количество слов, которые содержатся в исходной строке.
Примеры
входные данные
Hello , world!
выходные данные
2
4459 / 3212 / 1125
Регистрация: 21.03.2016
Сообщений: 7,949
Сообщение от KiritoSan
Слово — это последовательность подряд идущих латинских букв и знаков дефис, ограниченная с обоих концов
вот в этом и вся загвоздка
‘Сибирь–необъятный край’ ,будет считать как 3 слова хотя по условию
Сообщение от KiritoSan
Слово — это последовательность подряд идущих латинских букв и знаков дефис
то есть ‘Сибирь–необъятный’ надо считать как одно слово и вот эти условия нужно проверять что это дефис а не тире.
Функция str_word_count
Функция str_word_count подсчитывает количество слов в строке.
Функция может принимать второй необязательный параметр, число 1 или 2 . Если он не задан, то функция своим результатом возвращает целое число, равное количеству слов.
Если задано 1 , то возвращается массив, содержащий все слова, входящие в строку. Если задано 2 , то возвращается массив, ключами которого являются позиции в строке, а значениями — соответствующие слова.
Синтаксис
str_word_count(строка, [число]);
Пример
Давайте подсчитаем количество в строке:
Результат выполнения кода:
Смотрите также
- функцию substr_count ,
которая подсчитывает количество подстрок
Строки в Python
В языке Python строки — это тип данных, который используется для представления текста. Это один из базовых типов, с которым мы имеем дело в каждом проекте на Python.
Данная статья является полным руководством по использованию строк в Python. Прочитав ее, вы узнаете, как создавать строки и работать с ними. В частности, мы рассмотрим:
- создание строк
- индексацию строк
- работу с подстроками
- использование методов строк
И не только это!
Как создавать строки в Python
В Python вы можете создать строку, используя двойные или одинарные кавычки.
name = "Alice" hobby = 'golf'
Когда дело доходит до выбора одинарных или двойных кавычек, нужно быть последовательным. То есть вы можете использовать и те, и другие, но придерживайтесь одного стиля во всем проекте.
Применять строки и производить различные манипуляции с ними вам придется часто. Что касается «манипуляций», со строками можно делать множество вещей. Например, объединять, нарезать, изменять, находить подстроки и многое другое.
Далее поговорим об операторах строк.
Операторы строк
Возможно вы уже знаете об основных математических операторах Python.
От редакции Pythonist. На эту тему у нас есть статья «Операторы в Python».
С известной аккуратностью операторы сложения и умножения можно также применять и для строк:
- при помощи оператора сложения можно сложить две строки или более
- при помощи оператора умножения можно умножать строки.
В дополнении к этим двум операторам есть еще один, очень полезный. Он называется оператор in . С его помощью можно проверить, содержит ли строка определенную подстроку или символ.
Давайте рассмотрим подробнее, как работают эти операторы.
Оператор +
В Python вы можете объединить две или более строк с помощью оператора сложения (+).
part1 = "some" part2 = "where" word = part1 + part2 print(word) # Результат: # somewhere
Оператор *
Чтобы умножать строки в Python, можно использовать оператор умножения (*).
word = "hello" threeWords = word * 3 print(threeWords) # Результат: # hellohellohello
Оператор in
В Python оператор in можно использовать для проверки нахождения подстроки в строке.
Другими словами, с его помощью можно узнать, есть ли внутри строки определенное слово или символ.
Оператор in возвращает значение True , если внутри строки есть проверяемая подстрока. В противном случае возвращается значение False .
sentence = "This is just a test" testFound = "test" in sentence print(testFound) # Результат: # True
Теперь давайте рассмотрим другой пример. На этот раз проверим, есть ли в слове определенный символ:
word = "Hello" eFound = "e" in word print(eFound) # Результат: # True
Далее поговорим про индексацию строк.
Индексация строк
В Python строка представляет собой набор символов. Каждый символ строки имеет индекс — порядковый номер.
Благодаря этой индексации можно получить доступ к конкретному символу в данной строке, что весьма удобно.
Индексация строк Python начинается с нуля.
Это означает, что 1-й символ строки имеет индекс 0, 2-й символ имеет индекс 1 и так далее.
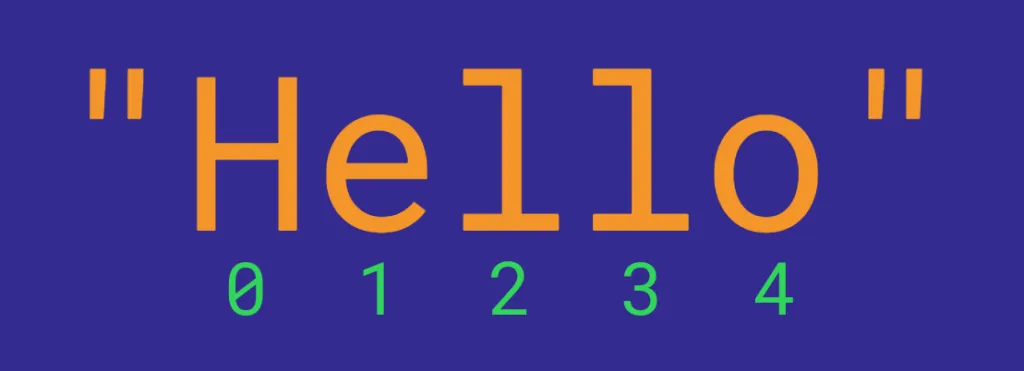
Чтобы получить доступ к символу с определенным индексом, нужно использовать квадратные скобки:
Это выражение возвращает i-й символ строки. Например:
word = "Hello" c1 = word[0] print(c1) # Результат: # H
Если индекс выходит за пределы длины строки, вы увидите ошибку IndexError .
Давайте рассмотрим следующий пример.
Новичку в программировании может быть трудно запомнить, что индексация начинается с 0. Например, последний символ строки из 5 символов имеет индекс 4 . Но давайте посмотрим, что произойдет, если вы вдруг подумаете, что это 5:
word = "Hello" last = word[5] print(last) # Результат: # IndexError: string index out of range
Как можно заметить, результатом является ошибка, указывающая, что индекс находится вне допустимого диапазона.
Это потому, что с индексом 5 мы пытаемся получить доступ к 6-му элементу. Но поскольку данная строка имеет только 5 символов, доступ к 6-му с треском проваливается.
Таким образом, следует быть осторожным и не пытаться получить доступ к отсутствующему элементу строки.
Нарезка (slicing) строк
Из предыдущего раздела стало ясно как получить доступ к определенному символу строки.
Но иногда требуется получить доступ к определенному диапазону внутри строки.
Сделать это можно при помощи так называемой нарезки строк.
Самый простой вариант операции нарезки требует указания начального и конечного индекса:
Результатом является срез символов исходной строки. В него входят символы от начального до конечного индекса (при этом символ с конечным индексом в срез не входит).
Например, возьмем первые три буквы строки:
word = "Hello" firstThree = word[0:3] print(firstThree) # Результат: # Hel
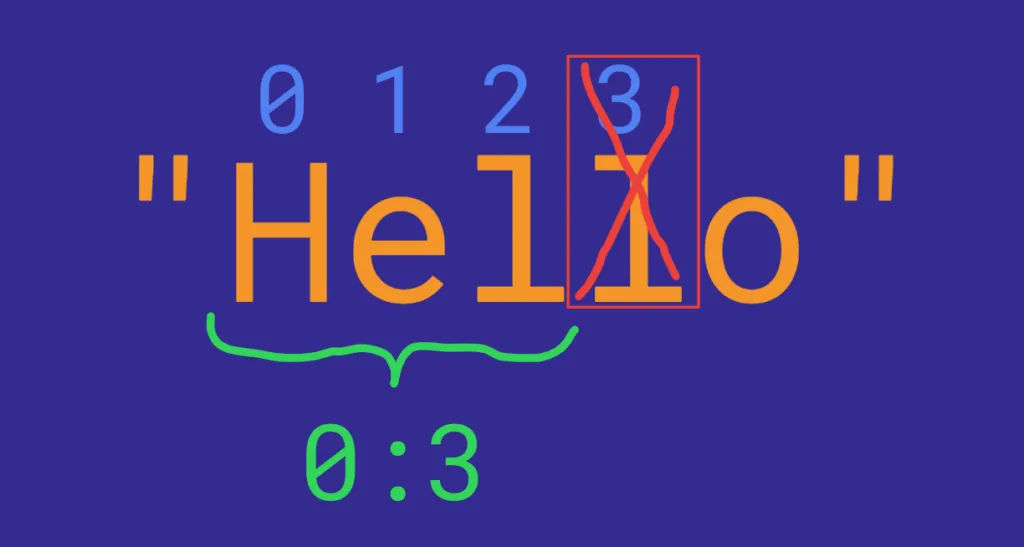
Полный синтаксис оператора среза включает в себя параметр шага и имеет следующий вид:
Параметр шага (step) указывает, через сколько символов следует перепрыгивать. По умолчанию он равен 1 , как вы наверно уже догадались.
Например, возьмем каждый второй символ из первых 8 символов строки:
word = "Hello world" firstThree = word[0:8:2] print(firstThree) # Результат: # Hlow
Теперь вы должны понимать основные принципы нарезки строк в Python.
На практике срезы применяются очень разнообразно. Например, некоторые или даже все параметры среза можно опускать, а отсчет символов может идти в обратном направлении.
Но чтобы не раздувать материал, здесь мы не будем вдаваться в детали срезов.
Встраивание переменных внутрь строки
Довольно часто возникает необходимость добавить переменные внутрь строки Python.
Для этого можно использовать F-строки. F-строка означает просто «форматированная строка». Она позволяет нам аккуратно размещать код внутри строки.
Чтобы создать F-строку, нужно добавить символ f непосредственно перед строкой и обозначить фигурными скобками код, внедряемый в строку.
name = "Alice" greeting = f"Hello, ! How are you doing?" print(greeting) # Результат: # Hello, Alice! How are you doing?
Как можно заметить, это аккуратным образом встраивает в строку имя, хранящееся в переменной name . Благодаря этому нам не нужно разбивать строку на три части, что было бы несколько неудобно.
Давайте рассмотрим еще один пример, чтобы убедиться, что внутри F-строки можно также запускать код:
calculation = f"5 * 6 = ." print(calculation) # Результат: # 5 * 6 = 30
От редакции Pythonist: на тему форматирования строк у нас есть отдельная статья — «Форматирование строк».
Изменение строк
В языке Python строки изменять нельзя.
Это связано с тем, что строки относятся к неизменяемым типам данных и представляет собой неизменяемые наборы символов.
От редакции Pythonist: на тему изменяемости объектов в Python рекомендуем почитать статью «Python 3: изменяемый, неизменяемый…».
Новичков это может несколько сбивать с толку.
Но изменять именно исходную строку приходится не часто, так что особых проблем неизменяемость строк не вызывает.
Если вам нужна измененная строка, можно просто создать новую строку из исходной с уже внесенными в нее изменениями. То есть новая строка является просто модифицированной копией исходной версии нашей строки.
На самом деле существует множество полезных встроенных методов для изменения строк. Эти методы помогают решить большинство повседневных задач.
И оставшаяся часть данной статьи будет посвящена именно этим методам.
Методы строк в языке Python
Во встроенном в Python модуле string есть множество удобных методов, которые можно использовать для работы со строками.
Они делают жизнь программиста гораздо проще.
Эти методы предназначены для решения самых общих задач, связанных как с изменением строк, так и с работой со строками в целом.
Например, можно заменить символ в строке при помощи метода replace() . Без этого метода это было бы не так просто сделать. Вам пришлось бы реализовать собственную логику для замены символа, так как непосредственное изменение строки невозможно.
И таких методов в Python довольно много. Если быть точными, то их 47. Не пытайтесь запомнить их все. Лучше почитайте про каждый из этих методов и попробуйте применить их.
Можно также добавить данную статью в закладки и возвращаться к ней потом по мере надобности.
Следующая таблица представляет собой шпаргалку с методами строк в Python. А ниже этой таблицы вы найдете более подробное описание каждого метода и пару полезных примеров по нему:
| Имя метода | Описание метода |
| capitalize | Преобразует первый символ строки в верхний регистр. |
| casefold | Преобразует строку в нижний регистр. Поддерживает больше вариантов, чем метод lower() . Используется при локализации либо глобализации строк. |
| center | Возвращает центрированную строку. |
| count | Возвращает количество вхождений символа или подстроки в строке. |
| encode | Производит кодировку строки. |
| endswith | Проверяет, заканчивается ли строка определенным символом либо определенной подстрокой. |
| expandtabs | Указывает размер табуляции для строки и возвращает его. |
| find | Ищет определенный символ или подстроку. Возвращает позицию, где он был впервые обнаружен. |
| format | Старый способ добавления переменных внутрь строки (выше мы рассмотрели современный метод F-строк). Форматирует строку, встраивая в нее значения и возвращая результат. |
| format_map | Форматирует определенные значения в строке. |
| index | Ищет символ или подстроку в строке. Возвращает индекс, по которому он был впервые обнаружен. |
| isalnum | Проверяет, все ли символы строки являются буквенно-цифровыми. |
| isalpha | Проверяет, все ли символы строки являются буквенными. |
| isascii | Проверяет, все ли символы строки являются символами ASCII. |
| isdecimal | Проверяет, все ли символы строки являются десятичными числами. |
| isdigit | Проверяет, все ли символы строки являются цифрами. |
| isidentifier | Проверяет, является ли строка идентификатором. |
| islower | Проверяет, все ли символы строки находятся в нижнем регистре. |
| isnumeric | Проверяет, все ли символы строки являются числами. |
| isprintable | Проверяет, все ли символы строки доступны для печати. |
| isspace | Проверяет, все ли символы строки являются пробелами. |
| istitle | Проверяет, соответствует ли строка правилам написания заголовков (каждое слово начинается с заглавной буквы). |
| isupper | Проверяет, все ли символы строки находятся в верхнем регистре. |
| join | Соединяет элементы итерируемого объекта (например, списка) в одну строку. |
| ljust | Возвращает выровненную по левому краю версию строки. |
| lower | Приведение всех символов строки к нижнему регистру. |
| lstrip | Удаляет пробелы слева от строки. |
| maketrans | Создает таблицу преобразования символов (для метода translate() ). |
| partition | Разбивает строку на три части. Искомая центральная часть указывается в качестве аргумента. |
| removeprefix | Удаляет префикс из начала строки и возвращает строку без него. |
| removesuffix | Удаляет суффикс из конца строки и возвращает строку без него. |
| replace | Возвращает строку, в которой определенный символ или подстрока заменены чем-то другим (другим символом или подстрокой). |
| rfind | Ищет в строке определенный символ или подстроку. Возвращает последний индекс, по которому он был найден. |
| rindex | Ищет в строке определенный символ или подстроку. Возвращает последний индекс, по которому он был найден (отличие данного метода от предыдущего только в том, что в случае неудачного поиска он возвращает ошибку). |
| rjust | Возвращает выровненную по правому краю версию строки. |
| rpartition | Разбивает строку на три части. Искомая центральная часть указывается в качестве аргумента. |
| rsplit | Разбивает строку по указанному разделителю и возвращает результат в виде списка. |
| rstrip | Удаляет пробелы справа от строки. |
| split | Разбивает строку по указанному разделителю и возвращает ее в виде списка элементов данной строки. |
| splitlines | Разбивает строку по разрывам (символам переноса строк) и возвращает список строк. |
| startswith | Проверяет, начинается ли строка с указанного символа или подстроки. |
| strip | Возвращает строку с удаленными пробелами с двух сторон. |
| swapcase | Все символы в верхнем регистре переводятся в нижний и наоборот. |
| title | Преобразует каждое слово строки так, чтобы оно начиналось с заглавной буквы. |
| translate | Возвращает переведенную строку. |
| upper | Переводит все символы строки в верхний регистр. |
| zfill | Заполняет строку символами 0 . |
Все строковые методы Python с примерами
В данном разделе дается более подробное описание каждого метода.
Помимо теории, для всех методов представлены полезные примеры.
Итак, начнем по порядку!
capitalize
Чтобы сделать первую букву строки заглавной, удобно использовать данный метод.
"hello, world".capitalize() # Результат: # Hello, world
casefold
Чтобы преобразовать все символы строки в нижний регистр, удобно использовать встроенный метод casefold() .
"HELLO, WORLD".casefold() # Результат: # hello world
Этот метод создает новую строку, переводя каждый символ строки в нижний регистр.
Разница между методами casefold() и lower() заключается в том, что метод casefold() умеет преобразовывать специальные буквы других языков. Другими словами, использование casefold() имеет смысл, когда ваше приложение должно поддерживать глобализацию или локализацию на другой язык.
Например, давайте преобразуем предложение на немецком языке, чтобы избавиться от большого двойного знака (ß). Это невозможно при использовании метода lower() :
"Eine Großes bier".lower() # eine großes bier" "Eine Großes bier".casefold() # eine grosses bier"
center
Метод center() используется, чтобы окружить (заполнить с двух сторон) строку заданными символами.
Этот метод имеет следующий синтаксис:
При вызове этого метода необходимо указать общее количество символов в строке и символ, которым строка будет окружена (заполнена с двух сторон).
Например, давайте добавим символы тире вокруг слова и сделаем всю строку длиной 20 символов:
txt = "banana" x = txt.center(20, "-") print(x) # Результат: # -------banana-------
count
Метод count() подсчитывает, сколько раз символ или подстрока встречается в строке.
Например, посчитаем количество букв l в предложении:
"Hello, world".count("l") # Возвращает 3
Или давайте посчитаем, сколько раз слово «Hello» встречается в этом же предложении:
"Hello, world".count("Hello") # Возвращает 1
encode
Чтобы изменить кодировку строки, используйте встроенный метод encode() .
Этот метод имеет следующий синтаксис:
Кодировкой по умолчанию является UTF-8. В случае неудачи кидается ошибка.
Например, давайте преобразуем строку в кодировку UTF-8:
title = 'Hello world' print(title.encode()) # Результат: # b'Hello world'
Этот метод можно вызвать с двумя необязательными параметрами:
- encoding: указывает тип кодировки;
- errors: определяет ответ при ошибке кодирования;
Существует 6 типов ошибок:
- strict
- ignore
- replace
- xmlcharrefreplace
- backslashreplace
Вот несколько примеров ASCII-кодировки с разными типами ошибок:
txt = "My name is Kimi Räikkönen" print(txt.encode(encoding="ascii", errors="ignore")) print(txt.encode(encoding="ascii", errors="replace")) print(txt.encode(encoding="ascii", errors="xmlcharrefreplace")) print(txt.encode(encoding="ascii", errors="backslashreplace")) print(txt.encode(encoding="ascii", errors="namereplace"))
b'My name is Kimi Rikknen' b'My name is Kimi R?ikk?nen' b'My name is Kimi Räikkönen' b'My name is Kimi R\\xe4ikk\\xf6nen' b'My name is Kimi R\\Nikk\\Nnen'
endswith
Данный метод применяется для проверки, заканчивается ли строка или ее часть заданным символом или подстрокой.
sentence = "Hello, welcome to my world." print(sentence.endswith(".")) # Результат: # True
expandtabs
При помощи метода expandtabs() можно указать размер табуляции. Этот метод полезен, если ваши строки содержат табы.
sentence = "H\te\tl\tl\to" print(sentence.expandtabs(1)) print(sentence.expandtabs(2)) print(sentence.expandtabs(3)) print(sentence.expandtabs(4)) print(sentence.expandtabs(5))
H e l l o H e l l o H e l l o H e l l o H e l l o
find
Метод find() находит индекс первого вхождения символа или подстроки в строку. Если совпадения нет, возвращается -1 .
Также можно указать диапазон, в котором выполняется поиск. Полный синтаксис для использования этого метода имеет следующий вид:
string.find(value, start, end)
sentence = "Hello world" x = sentence.find("world") print(x) # Результат: # 6
Это означает, что строку world можно найти по индексу 6 в заданном предложении.
В качестве другого примера давайте найдем подстроку в заданном диапазоне:
sentence = "This is a test" x = sentence.find("is", 3, 8) print(x) # Результат: # 5
format
Метод format() форматирует строку, встраивая в нее значения. Это несколько устаревший подход к форматированию строк в Python.
Метод format() имеет следующий синтаксис:
string.format(value1, value2, . , valuen)
Здесь value — это переменные, которые вставляются в строку. В дополнение к этому вам необходимо указать (при помощи фигурных скобок) места для этих переменных в строке.
Давайте посмотрим на следующий пример:
name = "John" age = 21 sentence = "My name is <> and I am <> years old".format(name, age) print(sentence) # Результат: # My name is John and I am 21 years old
format_map
Метод format_map() используется, чтобы напрямую преобразовать словарь в строку.
Вот его синтаксис:
Чтобы это работало, вам нужно указать (при помощи фигурных скобок) места в строке, куда будут помещены значения словаря.
data = sentence = "My name is and I am years old".format_map(data) print(sentence) # Результат: # My name is John and I am 21 years old
index
Метод index() находит индекс первого вхождения символа или подстроки в строку. Если он не находит значение, то вызывается исключение. Этим он отличается от метода find() .
Также можно указать диапазон, в котором будет производится поиск.
Синтаксис данного метода имеет следующий вид:
string.index(value, start, end)
sentence = "Hello world" x = sentence.index("world") print(x) # Результат: # 6
Это говорит о том, что подстроку world можно найти по индексу 6 в данной строке.
В качестве другого примера давайте найдем подстроку в заданном диапазоне:
sentence = "This is a test" x = sentence.index("is", 3, 8) print(x) # Результат: # 5
Разница между методами index() и find() заключается в том, что index() выдает ошибку, если не находит значения. Метод find() возвращает -1 .
isalnum
Чтобы проверить, являются ли все символы строки буквенно-цифровыми, используется метод isalnum() .
sentence = "This is 50" print(sentence.isalnum()) # Результат: # False
isalpha
Чтобы проверить, все ли символы строки являются буквами, используется метод isalpha() .
sentence = "Hello" print(sentence.isalpha()) # Результат: # True
isascii
Чтобы проверить, все ли символы строки являются ASCII символами, используется метод isascii() .
sentence = "Hello" print(sentence.isalpha()) # Результат: # True
isdecimal
Чтобы проверить, являются ли все символы строки числами в десятичной системе исчисления, используется метод isdecimal() .
sentence = "\u0034" print(sentence.isdecimal()) # Результат: # True
isdigit
Чтобы проверить, все ли символы строки являются числами, используется метод isdigit() .
sentence = "34" print(sentence.isdigit()) # Результат: # True
isidentifier
Чтобы проверить, все ли символы строки являются идентификаторами, используется метод isidentifier() .
- Строка считается идентификатором, если она содержит буквенно-цифровые буквы (a-z, 0-9) или знаки подчеркивания.
- Идентификатор не может начинаться с цифры.
sentence = "Hello" print(sentence.isidentifier()) # Результат: # True
islower
Чтобы проверить, находятся ли все символы строки в нижнем регистре, используется встроенный метод islower() .
"Hello, world".islower() # Результат: # False
Этот метод проверяет, все ли символы строки находятся в нижнем регистре. Если это так, он возвращает True . В противном случае False .
isnumeric
Чтобы проверить, все ли символы строки являются числами, используется метод isnumeric() .
sentence = "5000" print(sentence.isnumeric()) # Результат: # True
isprintable
Чтобы проверить, все ли символы строки доступны для печати, используется метод isprintable() .
sentence = "This a is test" print(sentence.isprintable()) # Результат: # True
isspace
Чтобы проверить, являются ли все символы строки пробелами, используется метод isspace() .
sentence = " " print(sentence.isspace()) # Результат: # True
istitle
Чтобы проверить, все ли первые символы каждого слова в строке начинаются с заглавной буквы, используется метод istitle() .
sentence = "Hello There This Is A Test" print(sentence.istitle()) # Результат: # True
isupper
Чтобы проверить, находятся ли все символы строки в верхнем регистре, используется встроенный метод isupper() :
"HELLO, WORLD".isupper() # Результат: # True
Этот метод проверяет, все ли символы строки в верхнем регистре. Если это так, он возвращает True . В противном случае False .
join
Чтобы объединить группу элементов (например, списка) в одну строку, используется метод join() .
words = ["This", "is", "a", "test"] sentence = " ".join(words) print(sentence) # Результат: # This is a test
ljust
Чтобы добавить определенные символы, например пробелы, справа от строки, используется метод ljust() .
Вот его синтаксис:
- num_characters: общая длина строки вместе с добавленными символами
- separator: символ, который добавляется в строку n раз, чтобы длина строки достигла заданного в предыдущем параметре значения
Например, добавим справа от строки символ тире:
print("Hello".ljust(20, "-")) # Результат: # Hello---------------
lower
Чтобы привести строку Python к нижнему регистру, используется встроенный метод lower() .
"HELLO, WORLD".lower() # Результат: # hello world
Этот метод создает новую строку, переводя каждый символ первоначальной строки в нижний регистр.
lstrip
Чтобы удалить начальные символы из строки, используется метод lstrip() .
По умолчанию этот метод удаляет все пробелы в начале строки.
print(" test".lstrip()) # Результат: # test
В качестве другого примера давайте удалим все дефисы в начале следующей строки:
print("---test---".lstrip("-")) # Результат: # test---
maketrans
Чтобы создать таблицу сопоставления строк, используется метод maketrans() . Эта таблица применяется вместе с методом translate() .
Синтаксис имеет следующий вид:
string.maketrans(a, b, c)
- Первый параметр a является обязательным. Если указан только он один, то он должен быть словарем, который определяет порядок замены строк. В противном случае параметр a должен быть строкой, которая показывает, какие символы нужно будет менять.
- Второй параметр b является необязательным. Он должен быть одинаковой длины с параметром a . Каждый символ в a будет заменен соответствующим символом в b .
- Третий параметр c также является необязательным. Он определяет, какие символы нужно будет удалить из исходной строки.
Например, заменим в предложении символы о на х :
sentence = "Hello World" trans_table = sentence.maketrans("o", "x") print(sentence.translate(trans_table)) # Результат: # Hellx Wxrld
partition
Чтобы разделить строку на три части, используется метод partition() . Он разбивает строку вокруг определенного символа или подстроки. Результат возвращается в виде кортежа.
Например, можно с его помощью разделить предложение вокруг заданного слова:
sentence = "This is a test" parts = sentence.partition("a") print(parts) # Результат: # ('This is', 'a', 'test')
removeprefix
Для удаления начала строки используется метод removeprefix() . Надо заметить, что это относительно новый метод, он работает только начиная с версии Python 3.9 и выше.
Например, давайте удалим слово This из данного предложения:
sentence = "This is a test" print(sentence.removeprefix("This")) # Результат: # is a test
removesuffix
Для удаления конца строки используется метод removesuffix(). Это также новый метод, он работает только с версией Python 3.9 и выше.
Например, давайте удалим из данного предложения последнее слово test:
sentence = "This is a test" print(sentence.removesuffix("test")) # Результат: # This is a
replace
Чтобы заменить символ или подстроку внутри строки на что-то другое, используется метод replace() :
Он имеет следующий синтаксис:
string.replace(old, new, count)
- old: символ или подстрока, которую вы хотите заменить
- new: то, на что вы хотите это поменять
- count: необязательный параметр (по умолчанию равен 1), определяет количество замен, которое необходимо произвести
sentence = "This is a test" updated_sentence = sentence.replace("This", "It") print(updated_sentence) # Результат: # It is a test
rfind
Для нахождения индекса последнего вхождения символа или подстроки в строку используется метод rfind() . При отсутствии совпадений возвращается значение -1 .
string.rfind(val, start, end)
- val: значение искомого символа или подстроки
- start: необязательный параметр, определяет индекс строки, с которого начинается поиск
- end: также необязательный параметр, определяет индекс строки, где поиск будет прекращен
sentence = "This car is my car" last_index = sentence.rfind("car") print(last_index) # Результат: # 15
rindex
Для нахождения индекса последнего вхождения символа или подстроки в строку также можно использовать метод rindex() . Но если вхождений найдено не будет, данный метод вызовет исключение. В этом его отличие от метода rfind() , который возвращает -1.
Его синтаксис имеет вид:
string.rindex(val, start, end)
- val: значение искомого символа или подстроки
- start: необязательный параметр, определяет индекс строки, с которого начинается поиск
- end: также необязательный параметр, определяет индекс строки, где поиск будет прекращен
sentence = "This car is my car" last_index = sentence.rindex("car") print(last_index) # Результат: # 15
rjust
Метод rjust() используется для добавления слева от строки определенных символов, например пробелов.
У него следующий синтаксис:
- num_characters: общая длина строки вместе с добавленными символами
- separator: символ, который следует добавлять слева от строки до достижения нужной длины
Например, добавим символы тире в начало строки:
print("Hello".rjust(20, "-")) # Результат: # ---------------Hello
rpartition
Данный метод разделяет строку на три части относительно последнего вхождения искомого символа или подстроки. Результат возвращается в виде кортежа.
sentence = "This car is my car, you cannot drive it" parts = sentence.rpartition("car") print(parts) # Результат: # ('This car is my ', 'car', ', you cannot drive it')
rsplit
Для разбиения строки по определенному разделителю начиная с правой стороны используется метод rsplit() . Результат возвращается в виде списка.
Его синтаксис имеет вид:
- separator: разделитель (символ или подстрока), на основе которого разбивается строка
- max: определяет максимальное количество разбиений, это необязательный параметр, если его не задавать, то данный метод работает точно так же, как split()
Например, давайте разделим справа строку, разделенную запятыми. Но при этом сделаем только одно разбиение:
items = "apple, banana, cherry" split_items = items.rsplit(",", 1) print(split_items) # Результат: # ['apple, banana', ' cherry']
Обратите внимание, что данный массив состоит только из двух строк.
rstrip
При помощи метода rstrip() можно удалять определенные символы, начиная с конца строки.
Если не указывать аргументов, данный метод будет пытаться удалять пробелы справа от строки.
Например, давайте удалим символ тире из строки:
print("Hello-----".rstrip("-")) # Результат: # Hello
split
При помощи метода split() строку можно превратить в список строк, разбив ее на части. Это один из наиболее широко используемых строковых методов Python.
По умолчанию данный метод разбивает строку на основе пробелов.
Вот его синтаксис:
- separator: необязательный параметр, символ или подстрока, на основании которой будет осуществляться разбиение
- max: также необязательный параметр, определяет количество предполагаемых разбиений
sentence = "This is a test" # Разбить по пробелам parts = sentence.split() print(parts) # Результат: # ['This', 'is', 'a', 'test']
В качестве другого примера давайте разобьем список, разделенный запятыми, ровно два раза, по двум первым запятым:
sentence = "Apple, Banana, Orange, Mango, Pineapple" parts = sentence.split(",", 2) print(parts) # Результат: # ['Apple', ' Banana', ' Orange, Mango, Pineapple']
Обратите внимание, что в данном списке только 3 элемента.
splitlines
Чтобы разбить текст, считанный в виде строки, по символам разрыва строки, используется метод splitlines() .
sentence = "Apple\nBanana\nOrange\nMango\nPineapple" parts = sentence.splitlines() print(parts) # Результат: # ['Apple', 'Banana', 'Orange', 'Mango', 'Pineapple']
Вы также можете оставить символы разрыва строк в конце каждой строки. Для этого нужно передать параметр True в качестве аргумента данного метода:
sentence = "Apple\nBanana\nOrange\nMango\nPineapple" parts = sentence.splitlines(True) print(parts) # Результат: # ['Apple\n', 'Banana\n', 'Orange\n', 'Mango\n', 'Pineapple']
startswith
Чтобы проверить, начинается ли строка с определенного значения, используется метод startwith() .
Вот его синтаксис:
string.startswith(val, start, end)
- val: значение, наличие которого хочется проверить
- start: необязательный параметр, целое число, определяющее индекс, с которого следует начать поиск
- end: также необязательный параметр, целое число, указывающее на индекс, на котором надо завершить поиск
sentence = "Hello world" print(sentence.startswith("Hello")) # Результат: # True
Теперь перейдем к другому примеру. На этот раз давайте посмотрим, есть ли в строке, начиная с 6-го индекса, подстрока wor :
sentence = "Hello world" print(sentence.startswith("wor", 6)) # Результат: # True
strip
Чтобы удалить определенные символы или подстроку из строки, используется метод strip() . По умолчанию этот метод удаляет пробелы. Также можно указать аргумент, который будет определять, какие именно символы нужно удалить.
Например, давайте удалим все символы тире из строки:
word = "--------test---" stripped_word = word.strip("-") print(stripped_word) # Результат: # test
swapcase
Чтобы сделать строчные буквы заглавными, а заглавные строчными, используется метод swapcase() .
"HELLO, world".swapcase() # Результат: # hello, WORLD
Этот метод создает новую строку, заменяя все заглавные буквы на строчные и наоборот.
title
Чтобы сделать первую букву каждого слова в строке заглавной, используется метод title() .
"hello, world".title() # Результат: # Hello, World
Этот метод создает новую строку, делая первую букву каждого слова заглавной.
translate
Чтобы заменить определенные символы строки на другие символы, используется метод translate() .
Но прежде чем это делать, нужно создать таблицу сопоставления при помощи метода maketrans() .
Например, давайте заменим буквы о на х :
sentence = "Hello World" trans_table = sentence.maketrans("o", "x") print(sentence.translate(trans_table)) # Результат: # Hellx Wxrld
upper
Чтобы преобразовать строку Python в верхний регистр, используется встроенный метод upper() .
"Hello, world".upper() # Результат: # HELLO WORLD
Этот метод создает новую строку, переводя каждый символ исходной строки в верхний регистр.
zfill
Данный метод добавляет нули перед исходной строкой.
В качестве аргумента нужно передать желаемую длину строки и, метод добавит нужное количество нулей перед строкой.
word = "Test" filled_word = word.zfill(10) print(filled_word) # Результат: # 000000Test
Обратите внимание, что общая длина этой строки теперь равна 10.
Заключение
Видите как много существует методов строк!
Надеюсь, вам понравилась эта статья!
Подсчет количества слов в строке
Подсчитать количество слов во введенной пользователем строке. Считаем, что слова разделяются исключительно одним пробелом, а первый и последний символы строки не являются пробелами.
str — строка;
len — длина строки;
count — счетчик слов в строке.
Алгоритм решения задачи:
- Измеряем длину введенной пользователем строки.
- Устанавливаем счетчик слов в значение 0.
- В цикле посимвольно перебираем строку. Если очередной символ является пробелом, увеличиваем счетчик слов.
- Поскольку в цикле не было учтено последнее слово (после него нет пробела), мы должны после цикла увеличить счетчик слов на единицу. Однако, если была введена пустая строка, то этого делать не надо. Поэтому перед увеличением счетчика добавляем проверку, что длина строки больше нуля.
Программа на языке Паскаль:
var str: string; len, count, i: integer; begin readln(str); len := length(str); count := 0; for i := 0 to len do if str[i] = ' ' then count := count + 1; if len > 0 then count := count + 1; writeln(count); end.one two three 3Примечание. Программа не будет корректно работать, если слова разделены больше, чем одним пробелом.
Второй вариант задачи: подсчитать количество слов в строке и вывести длину каждого слова.
var str, s: string; arr: array[1..255] of string; n,i,l: byte; begin readln(str); l := length(str); n := 0; s := ''; for i:=1 to l do if ((str[i] = ' ') or (i = l)) and (s <> '') then begin n := n + 1; if (i = l) and (str[i] <> ' ') then s := s + str[i]; arr[n] := s; s := ''; end else if str[i] <> ' ' then s := s + str[i]; writeln(n); for i:=1 to n do writeln(arr[i],' - ', length(arr[i])); end.Пример выполнения программы:
one two three 3 one - 3 two - 3 three - 5
Третий вариант задачи: Подсчитать количество слов в строке и вывести все слова в столбик.
var s, w: string; l,i: byte; count: byte; begin readln(s); l := length(s); w := ''; count := 0; for i:=1 to l do if s[i] <> ' ' then w := w + s[i] else if w <> '' then begin writeln(w); w := ''; count := count + 1; end; if w <> '' then begin // последнее слово после которого нет пробела writeln(w); count := count + 1; end; writeln(count); end.