Кластеризация, которую легко осуществить с помощью PyCaret

Содержание данной статьи изначально было опубликовано в последней книге автора статьи «Упрощение машинного обучения с PyCaret». Вы можете кликнуть здесь, чтобы ознакомиться с ней подробнее.
Одной из фундаментальных задач неконтролируемого машинного обучения является кластеризация. Цель этой задачи — классифицировать экземпляры заданного набора данных в различные кластеры на основе их общих характеристик. Кластеризация имеет множество практических применений в различных областях, включая маркетинговые исследования, анализ социальных сетей, биоинформатику, медицину и другие. В этой статье мы рассмотрим пример кластеризации с помощью PyCaret, библиотеки Python, которая поддерживает все основные задачи машинного обучения, такие как регрессия, классификация, кластеризация и обнаружение аномалий. PyCaret упрощает рабочий процесс машинного обучения, следуя лоукод-концепции, что делает ее отличным выбором как для новичков, так и для экспертов, которые хотят быстро создавать прототипы ML-моделей.
Требования к программному обеспечению
Код из статьи должен работать на всех основных операционных системах, т.е. Microsoft Windows, Linux и Apple macOS. На вашем компьютере необходимо инсталлировать Python 3, а также JupyterLab. Я предлагаю вам использовать Anaconda, набор инструментов для машинного обучения и даталогии, который включает в себя множество полезных библиотек и программных пакетов. Anaconda можно свободно загрузить по этой ссылке. В качестве альтернативы вы можете использовать облачный сервис, например, Google Colab, чтобы выполнять код на Python, не беспокоясь об установке чего-либо на вашем компьютере. Создайте новый блокнот Jupyter и введите код или загрузите его из этого репозитория Github.
Инсталляция PyCaret
Библиотеку PyCaret можно установить локально, выполнив следующую команду в терминале Anaconda. Эту же команду можно выполнить на Google Colab или аналогичном сервисе, чтобы установить библиотеку на удаленном сервере.
pip install pycaret[full]==2.3.4После выполнения этой команды PyCaret будет инсталлирован, и вы сможете запустить все приведенные в статье примеры кода. Рекомендуется также установить дополнительные зависимости, включив спецификатор [full] . Кроме того, установка правильной версии пакета гарантирует максимальную совместимость, так как я использовал PyCaret ver. 2.3.4 во время работы над этой статьей. Наконец, создание среды conda для PyCaret считается лучшей практикой, так как это поможет вам избежать конфликтов с другими пакетами и убедиться, что у вас всегда инсталлированы правильные зависимости.
Кластеризация K-Means
Кластеризация K-Means¹ (К-средних) является одним из самых популярных и простых методов кластеризации, что делает его простым для понимания и реализации в коде. Он определяется следующей формулой.

K — это количество всех кластеров, а C представляет каждый отдельный кластер. Наша цель — минимизировать W, который является мерой внутрикластерной вариации.

Существуют различные способы определения внутрикластерной вариации, но наиболее распространенным является квадратичное евклидово расстояние, как видно из приведенного выше уравнения. В результате получается следующая форма кластеризации K-Means, где W заменяется формулой евклидова расстояния.

Кластеризация с помощью PyCaret
K-Means является наиболее распространенным методом, но существует множество других, таких как Affinity Propagation², Spectral Clustering³, Agglomerative Clustering⁴, Mean Shift Clustering⁵ и Density-Based Spatial Clustering (DBSCAN)⁶. Сейчас мы увидим, как модуль кластеризации PyCaret может помочь нам легко обучить модель и оценить ее эффективность.
import numpy as np import pandas as pd import matplotlib.pyplot as plt import matplotlib as mpl import seaborn as sns from pycaret.clustering import * from sklearn.datasets import make_blobs mpl.rcParams['figure.dpi'] = 300Начнем с импорта некоторых стандартных библиотек Python, включая NumPy, pandas, Matplotlib и Seaborn. Мы также импортируем функции кластеризации PyCaret, и функцию make_blobs() scikit-learn, которая может быть использована для создания датасетов. Наконец, устанавливаем DPI рисунка Matplotlib на 300, чтобы получить графики высокого разрешения. Включение этого параметра не обязательно, поэтому при желании вы можете удалить последнюю строку.
Генерация синтетического датасета
cols = ['column1', 'column2', 'column3', 'column4', 'column5'] arr = make_blobs(n_samples = 1000, n_features = 5, random_state =20, centers = 3, cluster_std = 1) data = pd.DataFrame(data = arr[0], columns = cols) data.head()
data.info() RangeIndex: 1000 entries, 0 to 999 Data columns (total 5 columns): # Column Non-Null Count Dtype --- ------ -------------- ----- 0 column1 1000 non-null float64 1 column2 1000 non-null float64 2 column3 1000 non-null float64 3 column4 1000 non-null float64 4 column5 1000 non-null float64 dtypes: float64(5) memory usage: 39.2 KBВместо того чтобы загружать реальный датасет, мы будем генерировать синтетический, используя функцию make_blobs() scikit-learn. Эта функция генерирует датасеты, подходящие для моделей кластеризации, и имеет различные параметры, которые могут быть изменены в соответствии с нашими потребностями. В данном случае мы создали датасет с 1000 экземплярами, 5 признаками и 3 отдельными кластерами. Использование синтетического датасета для тестирования нашей модели кластеризации имеет различные преимущества, главным из которых является то, что мы уже знаем фактическое количество кластеров, и поэтому сможем легко оценить производительность модели. Реальные данные обычно сложнее, т.е. не всегда имеют четко разделенные кластеры, но работа с простым датасетом позволит лучше ознакомиться с инструментами и рабочим процессом.
Исследовательский анализ данных
data.hist(bins = 30, figsize = (12,10), grid = False) plt.show()
Функция hist() pandas позволяет нам легко визуализировать дистрибьюцию каждой переменной. Мы видим, что все распределения переменных являются бимодальными или мультимодальными, т.е. имеют два или более пиков. Обычно это происходит, когда датасет содержит несколько групп с различными характеристиками. В данном случае датасет был специально создан для того, чтобы содержать 3 отдельных кластера, поэтому вполне разумно, что переменные имеют мультимодальное распределение.
plt.figure(figsize=(10, 8)) sns.heatmap(data.corr().round(decimals=2), annot=True) plt.show()
Для создания тепловой карты, визуализирующей значения корреляции всех пар переменных, были использованы функция corr() pandas, а также функция heatmap() Seaborn. Мы видим, что столбец2 и столбец3 имеют сильную линейную зависимость со значением корреляции 0,93. То же самое верно для столбца3 и столбца4, значение корреляции которых составляет 0,75. С другой стороны, столбец1 имеет обратную корреляцию со всеми другими столбцами, но особенно со столбцом5, со значением -0,85.
plot_kws = , 'line_kws': > sns.pairplot(data, kind='reg', vars=data.columns[:-1], plot_kws=plot_kws) plt.show()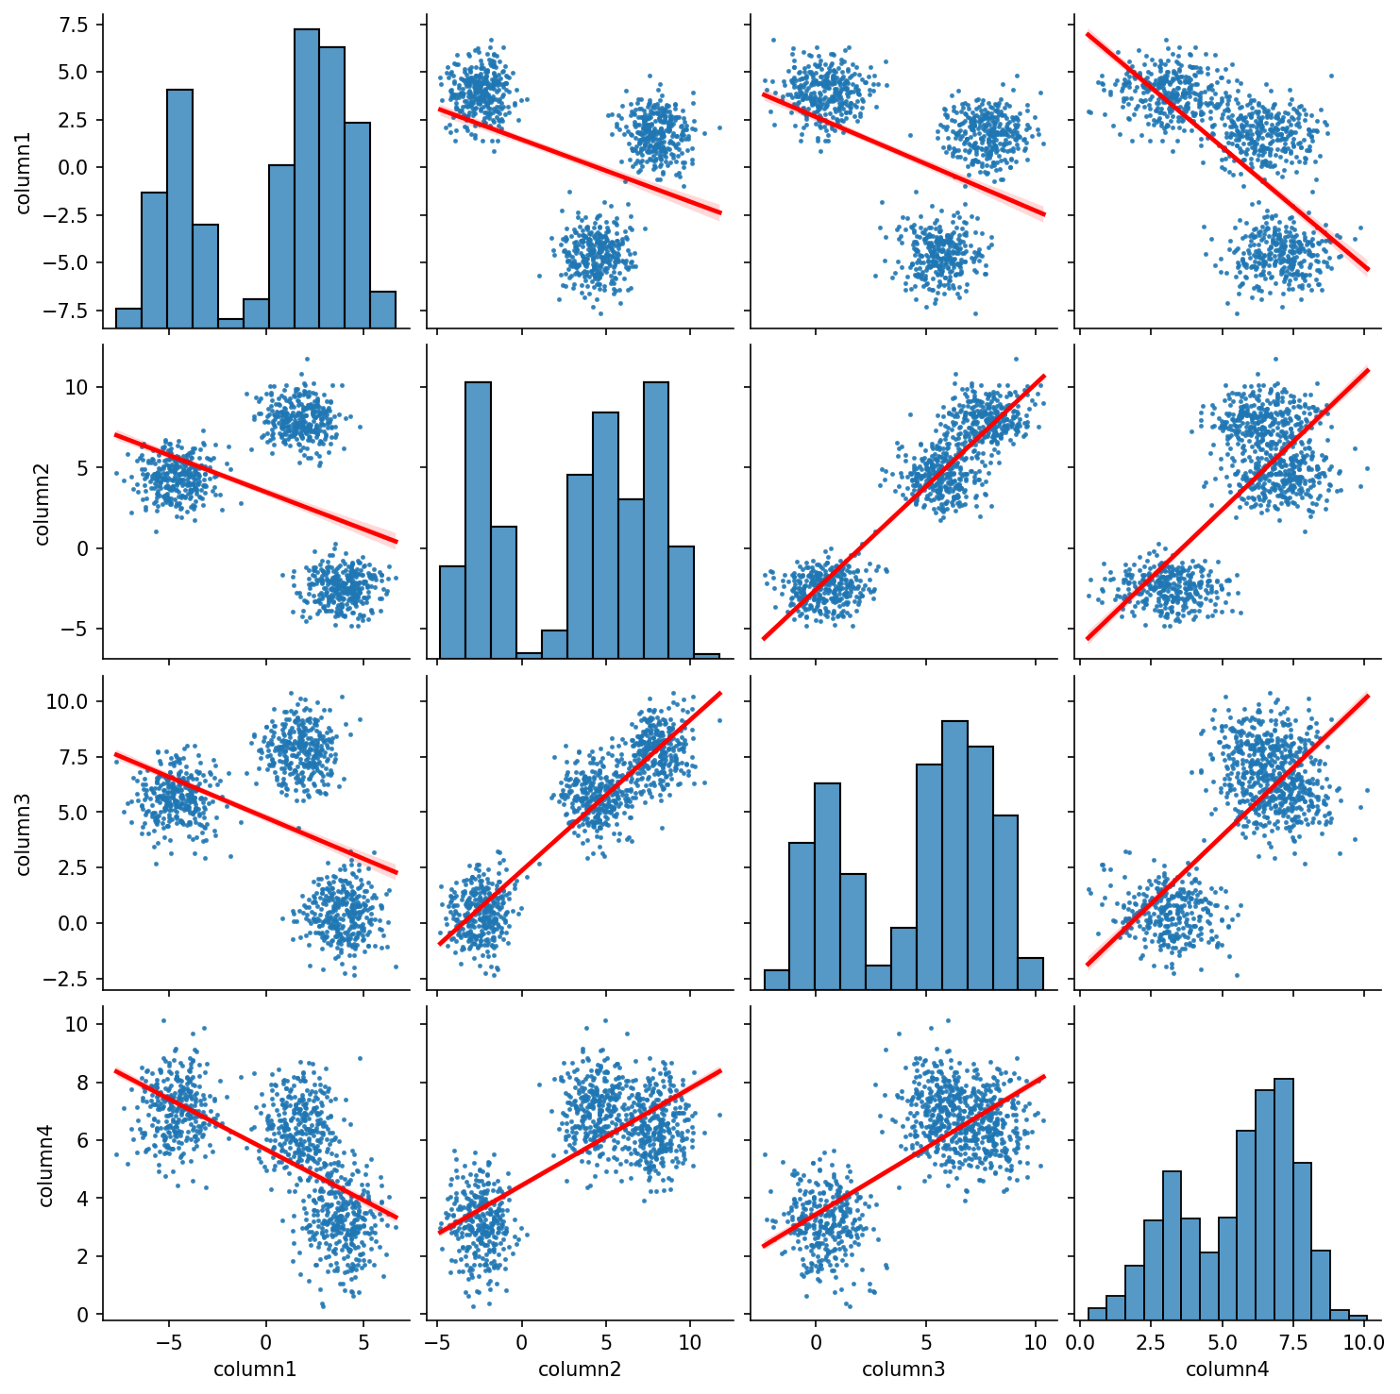
Мы использовали функцию pairplot() Seaborn для создания матрицы диаграмм разброса для синтетического датасета, диагональ которой представляет собой гистограмму каждой переменной. Кластеры датасета видны на диаграммах разброса, что указывает на то, что они четко отделены друг от друга. Как и ранее на тепловой карте корреляции, мы видим, что некоторые пары переменных имеют сильную линейную связь, а другие — обратную линейную связь. Это выделяется линиями регрессии, которые были включены в каждую диаграмму рассеяния путем установки параметра kind функции pairplot() на reg .
Инициализация среды PyCaret
cluster = setup(data, session_id = 7652)
После завершения исследовательского анализа данных (Exploratory Data Analysis. EDA) мы собираемся использовать функцию setup() для инициализации среды PyCaret. При этом будет создан пайплайн, который подготовит данные для обучения и развертывания модели. В данном случае настройки по умолчанию являются приемлемыми, поэтому мы не будем изменять ни один из параметров. Тем не менее, такая мощная функция обладает многочисленными возможностями по предварительной обработке данных, поэтому вы можете обратиться к странице документации модуля PyCaret Clustering, чтобы узнать об этом более подробно.
Создание модели
model = create_model('kmeans')
Функция create_model() позволяет нам легко создавать и оценивать предпочитаемую модель кластеризации, например, алгоритм K-Means. По умолчанию эта функция создает 4 кластера, поэтому достаточно установить параметр num_clusters равным 3, так как это является правильным числом. Вместо этого мы будем следовать подходу, характерному для реальных датасетов, где число кластеров, как правило, неизвестно. После выполнения функции выводится ряд показателей производительности, включая Silhouette⁷, Calinski-Harabasz⁸ и Davies-Bouldin⁹. Мы сосредоточимся на коэффициенте Silhouette, который определяется следующим уравнением.

- s(i) — коэффициент Silhouette для экземпляра i датасета.
- a(i) — среднее внутрикластерное расстояние i.
- b(i) — среднее расстояние до ближайшего кластера i.
Полученное значение метрики — это средний коэффициент Silhouette для всех экземпляров, имеющий диапазон от -1 до 1. Отрицательные значения указывают на то, что экземпляр был определен в неправильный кластер, а значения, близкие к 0, указывают на то, что кластеры перекрываются. С другой стороны, положительные значения, близкие к 1, указывают на правильное распределение. В нашем примере значение равно 0,5822, что говорит о том, что производительность модели может быть улучшена путем подбора оптимального количества кластеров для данного датасета. Далее мы рассмотрим, как этого можно добиться с помощью «метода локтя» (elbow method).
plot_model(model, 'elbow')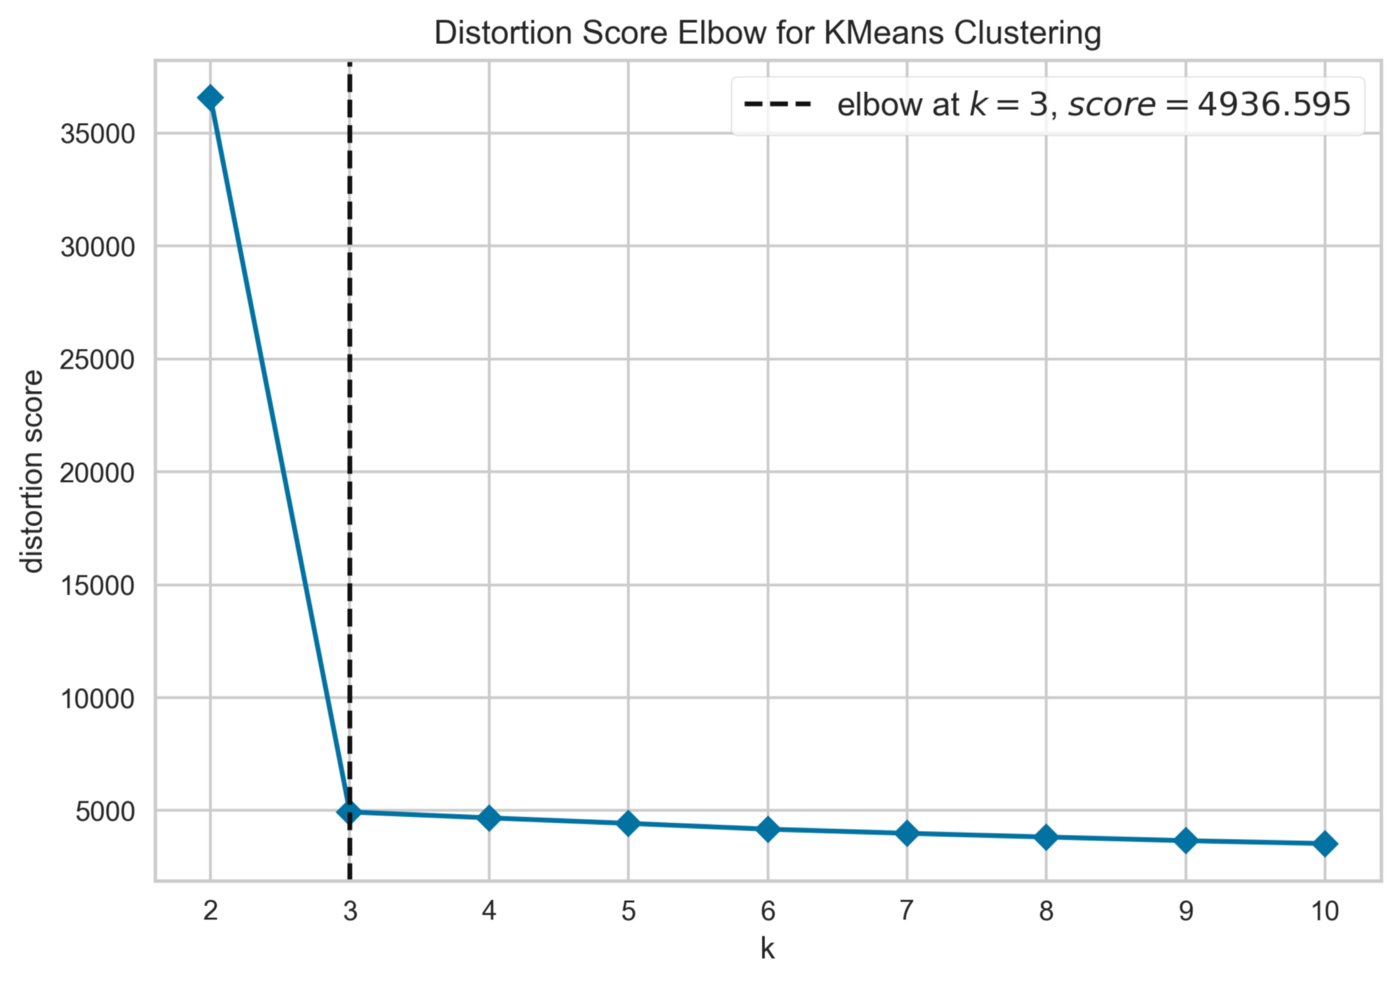
Функция plot_model() позволяет нам создавать различные полезные графики для нашей модели. В данном случае мы создали график локтя, который поможет нам найти оптимальное количество кластеров для модели K-Means. Метод локтя обучает модель кластеризации для ряда значений K и визуализирует оценку искажения для каждого из них¹⁰. Точка перегиба на кривой — известная как локоть — является показателем оптимального значения для K. Как и ожидалось, на графике есть локоть при K = 3, выделенный пунктирной вертикальной линией.
model = create_model('kmeans', num_clusters = 3)
После использования метода локтя для поиска оптимального количества кластеров мы снова проводим обучение модели K-Means. Как видно, средний коэффициент Silhouette увеличился до 0,7972, что указывает на улучшение работы модели и лучшее распределение кластеров для каждого экземпляра датасета.
Построение графика модели
plot_model(model, 'cluster')
Как было показано ранее, plot_model() — полезная функция, которую можно использовать при построении различных видов графиков для нашей модели кластеризации. В данном случае мы создали 2D график метода анализа главных компонент (Principal Component Analysis. PCA) для модели K-Means. PCA может использоваться для проецирования данных в пространство более низкой размерности с сохранением большей части дисперсии¹¹, эта техника известна как уменьшение размерности. После применения PCA к синтетическому датасету исходные 5 характеристик были редуцированы до 2 главных компонент. Кроме того, мы видим, что кластеры четко разделены, и все экземпляры датасета были назначены в правильный кластер.
Сохранение и назначение модели
save_model(model, 'clustering_model') results = assign_model(model) results.head(10)
Функция save_model() позволяет нам сохранить модель кластеризации на локальном диске для дальнейшего использования или развертывания в качестве приложения. Модель хранится в виде pickle-файла, который может быть загружен с помощью комплементарной функции load_model() . Кроме того, функция assign_model() возвращает синтетический датасет с дополнительным столбцом для кластерных меток, которые были присвоены экземплярам датасета.
Заключение
Надеюсь, что представленное в этой статье тематическое исследование поможет вам лучше освоить модуль кластеризации PyCaret. Я также призываю читателей экспериментировать с другими датасетами и самостоятельно практиковать вышеупомянутые техники. Если вы хотите узнать больше о PyCaret, то можете ознакомиться с книгой Simplifying Machine Learning with Pycaret, которую я недавно опубликовал.
Сегодня в 20:00 состоится открытое занятие «Знакомство с Jupyter Notebook, основы Python». На нем познакомимся с Python и средой разработки Jupiter Notebook, а также узнаем, какие бывают типы данных и виды арифметических операций. Регистрация доступна по ссылке.
- python
- анализ данных
- PyCaret
- кластеризация
- машинное обучение
- Jupyter Notebook
- Блог компании OTUS
- Python
- Машинное обучение
Реализация кластеризации методом k-средних на Python (с визуализацией)
Кластеризация — разбиение множества объектов на подмножества, называемые кластерами. Кластеризация, будучи математическим алгоритм имеет широкое применение во многих сферах: начиная с таких естественно научных областей как биология и физиология, и заканчивая маркетингом в социальных сетях и поисковой оптимизацией.
Существует множество алгоритмов кластеризации, однако ниже будет рассмотрен метод k-средних, так как он является наиболее лаконичным и простым для понимания.
Кластеризация методом k-средних:
Исходной задачей будет распределение произвольного количества n-мерных точек по k кластерам.
- Случайным образом создаются k точек, в дальнейшем будем называть их центрами кластеров;
- Для каждой точки ставится в соответствии ближайший к ней центр кластера;
- Вычисляются средние арифметические точек, принадлежащих к определённому кластеру. Именно эти значения становятся новыми центрами кластеров;
- Шаги 2 и 3 повторяются до тех пор, пока пересчёт центров кластеров будет приносить плоды. Как только высчитанные центры кластеров совпадут с предыдущими, алгоритм будет окончен.
Приступим к реализации алгоритма:
Исходные данные алгоритма:
- n — количество строк;
- k — количество кластеров;
- dim — размерность точек (пространства).
Выходные данные алгоритма:
- cluster — двумерный массив размерностью dim * k, содержащий k точек — центры кластеров;
- cluster_content — массив, содержащий в себе k массивов — массивов точек принадлежащих соответствующему кластеру.
def clusterization(array, k): n = len(array) dim = len(array[0]) cluster = [[0 for i in range(dim)] for q in range(k)] cluster_content = [[] for i in range(k)] for i in range(dim): for q in range(k): cluster[q][i] = random.randint(0, max_cluster_value) cluster_content = data_distribution(array, cluster)Переменные заданы. Первичные центры кластеров созданы с помощью библиотеки random(стр. 9 — 11) max_claster_value — константа задающая примерные границы исходного множества;
При помощи функции data_ditribution() произведено первичное распределения точек по кластерам (стр. 13). Рассмотрим эту функцию подробнее:
def data_distribution(array, cluster): cluster_content = [[] for i in range(k)] for i in range(n): min_distance = float('inf') situable_cluster = -1 for j in range(k): distance = 0 for q in range(dim): distance += (array[i][q]-cluster[j][q])**2 distance = distance**(1/2) if distance < min_distance: min_distance = distance situable_cluster = j cluster_content[situable_cluster].append(array[i]) return cluster_contentДля каждой строчки (стр. 5) высчитывается расстояние до каждого центра кластеров. Здесь применяется стандартный алгоритм:

- За начальное кратчайшее расстояние (min_distance) берётся несоизмеримо большое со значениями точек число;
- Затем происходит вычисление расстояния до центра каждого кластера;
- Если вычисленное расстояние меньше минимального, то минимальное расстояние приравнивается к вычисленному и точка привязывается к этому кластеру (situable_cluster);
- После обработки точки, в массив cluster_content в выбранный кластер (situable_cluster) кластер вкладывается значение точки.
Функция возвращает массив cluster_content.
В дальнейшем, как и полагается, данная последовательность действий обращается в цикл:
privious_cluster = copy.deepcopy(cluster) while 1: cluster = cluster_update(cluster, cluster_content, dim) cluster_content = data_distribution(array, cluster) if cluster == privious_cluster: break privious_cluster = copy.deepcopy(cluster)Данный цикл целостным образом описывает шаг 4 из описании алгоритм k-средних (см. выше).
После распределения точек по центрам кластеров происходит перераспределение уже центров кластеров по привязанным к ним точкам (стр. 2). Рассмотрим функцию cluster_content() подробнее:
def cluster_update(cluster, cluster_content, dim): k = len(cluster) for i in range(k): #по i кластерам for q in range(dim): #по q параметрам updated_parameter = 0 for j in range(len(cluster_content[i])): updated_parameter += cluster_content[i][j][q] if len(cluster_content[i]) != 0: updated_parameter = updated_parameter / len(cluster_content[i]) cluster[i][q] = updated_parameter return clusterДля каждого кластера, для каждого из n измерений вычисляется новое значения с помощью незамысловатого среднего арифметического: стр. 8-9 — складываются все значения; стр. 11-12 — сумма делится на количество точек в кластере; стр. 13 — кластер принимает обновлённое значение.
На данном месте алгоритм заканчивает свою работу. Полный алгоритм выглядит следующим образом:
def clusterization(array, k): n = len(array) dim = len(array[0]) cluster = [[0 for i in range(dim)] for q in range(k)] cluster_content = [[] for i in range(k)] for i in range(dim): for q in range(k): cluster[q][i] = random.randint(0, max_cluster_value) cluster_content = data_distribution(array, cluster) privious_cluster = copy.deepcopy(cluster) while 1: cluster = cluster_update(cluster, cluster_content, dim) cluster_content = data_distribution(array, cluster) if cluster == privious_cluster: break privious_cluster = copy.deepcopy(cluster)Перейдём к визуализации:
Визуализируем результат алгоритма для 3-х и 2-х мерного исходных пространств. Воспользуемся библиотекой mathplotlib:
import matplotlib.pyplot as plt from mpl_toolkits import mplot3d import numpy as npВизуализация для 2-х мерного пространства происходит следующим образом:
def visualisation_2d(cluster_content): k = len(cluster_content) plt.grid() plt.xlabel("x") plt.ylabel("y") for i in range(k): x_coordinates = [] y_coordinates = [] for q in range(len(cluster_content[i])): x_coordinates.append(cluster_content[i][q][0]) y_coordinates.append(cluster_content[i][q][1]) plt.scatter(x_coordinates, y_coordinates) plt.show()Grid() — создание сетки. xlabel(), ylabel() — названия осей. Затем в массивы, соответствующие осям вкладываются значения точек. После такой операции для каждого кластера вызывается функция scatter() — разброс точек по плоскости. В конце вызывается функция отображения — show().


Аналогичным образом визуализируется результат алгоритма для 3-х мерного пространства:
def visualisation_3d(cluster_content): ax = plt.axes(projection="3d") plt.xlabel("x") plt.ylabel("y") k = len(cluster_content) for i in range(k): x_coordinates = [] y_coordinates = [] z_coordinates = [] for q in range(len(cluster_content[i])): x_coordinates.append(cluster_content[i][q][0]) y_coordinates.append(cluster_content[i][q][1]) z_coordinates.append(cluster_content[i][q][2]) ax.scatter(x_coordinates, y_coordinates, z_coordinates) plt.show()


Таким образом, мы выполнили необходимые и достаточные условия для анализа и реализации кластеризации методом k-средних.
Группировка пользователей методами кластеризации данных
Данные не только не всегда очевидно указывают на определенную группу, порой непонятно даже сколько таких групп. Для решения подобного рода проблем существует целый класс задач машинного обучения — кластеризация. Данный класс задач относится к категории unsupervised learning, то есть обучение без размеченных данных, поэтому является очень ценным в условиях, когда исследование только начинается. Эта статья посвящена решению проблемы группировки пользователей по собранной статистике методами кластеризации.
Возьмем для примера данные пользователей, которые заходили на сайт компании и кликали на ссылки. При помощи подходящего link tracker посчитаем количество кликов по тем или иным элементам сайта за определенное время от каждого зарегистрированного пользователя, просуммируем, например, по неделям и пронормируем на среднее. Для примера рассмотрим сгенерированный датасет.
Начнем с генерации сета, имитирующего поведение трех групп пользователей, кликающих по 5 ссылкам с 1000 разных аккаунтов. Для этого воспользуемся методом make_blobs из пакета sklearn.
from sklearn.datasets import make_blobs import numpy as np data, pregenerated= make_blobs(1000,n_features=5,cluster_std=4)В массив data будут записаны пять фич, каждая из которых является суммой трех гауссиан с центрами в трех разных точках, которые и являются кластерами. Имена этих заранее известных кластеров записаны в переменной pregenerated. Построим фичи друг относительно друга:
from pandas.plotting import scatter_matrix import pandas as pd scatter_matrix(pd.DataFrame(data), alpha=0.2, figsize=(6, 6), ) pd.Series(pregenerated).value_counts()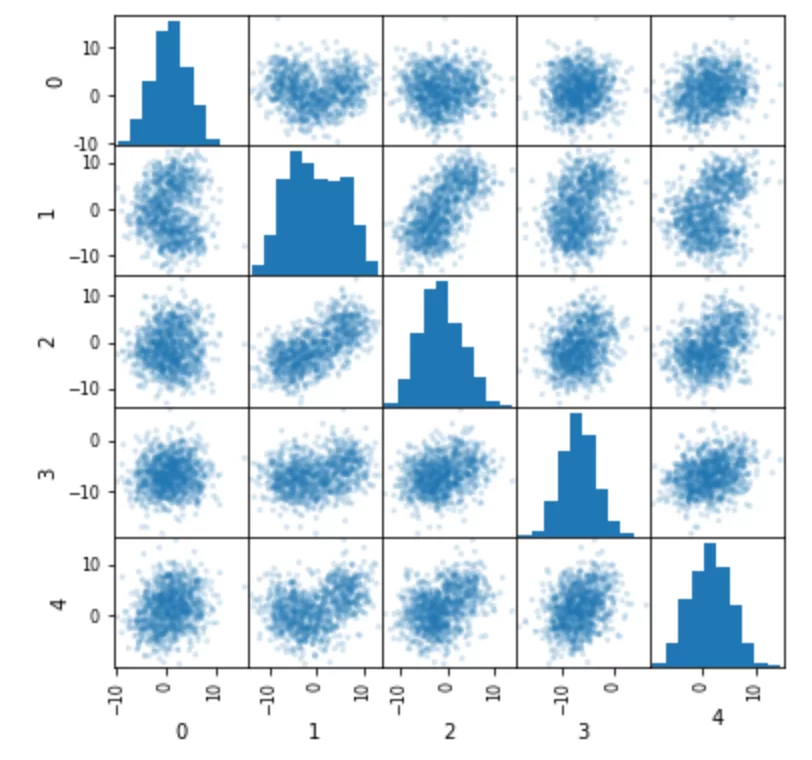
Видно, что по фичам ничего невозможно понять — даже сколько там кластеров. Это весьма похоже на реальные данные. Преобразуем массив данных в датасет и назовем фичи так, как будто это и есть реальные данные.
result_df = pd.DataFrame(data) result_df.columns = ["каталог","доставка","о нас","реклама","адреса"] result_df["группа"] = pregenerated result_df.head() 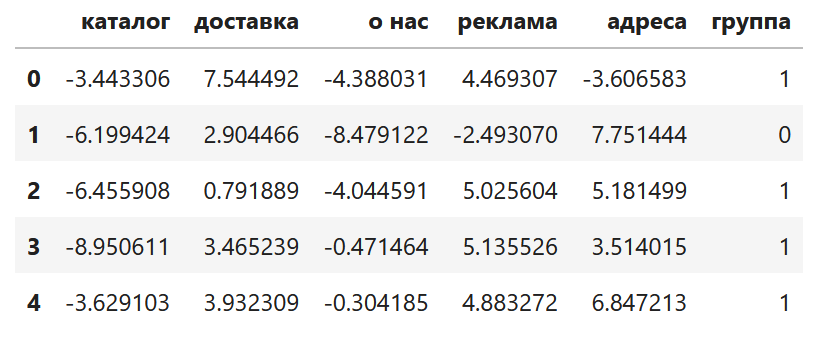
Далее понаблюдаем, как даже самый базовый метод кластеризации легко справляется с задачей группировки данных. Прогоним полученный датасет через популярную модель для кластеризации — k-means. Ее главный минус в том, что нужно знать заранее количество кластеров. Обычно это решается либо эмпирически, либо моделями способными на поиск количества кластеров, таких как DBSCAN. У нас же количество кластеров известно заранее.
from sklearn.cluster import KMeans kmeans = KMeans(n_clusters=3).fit(data)Для валидации построим распределение как изначальных, так и предсказанных кластеров.
result_df["предсказанные"] = kmeans.labels_ print(result_df["группа"].value_counts()) print(result_df["предсказанные"].value_counts()) result_df.head()Name: группа, dtype: int64
Name: предсказанные, dtype: int64
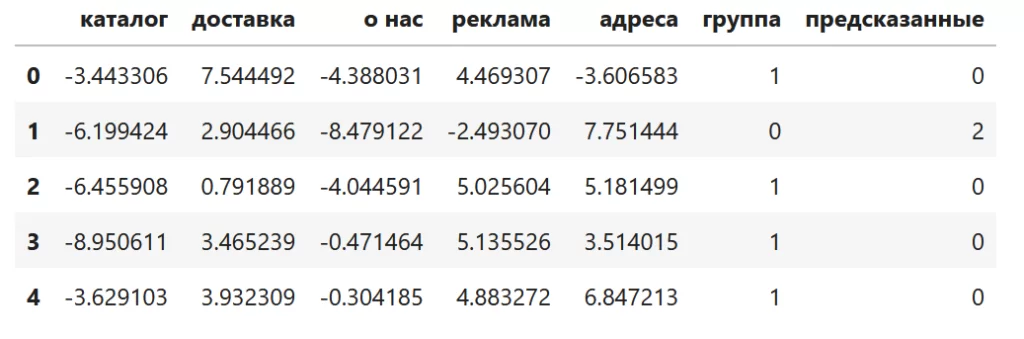
Поскольку мы заранее знали к какому кластеру принадлежит тот или иной пользователь — мы ведь их сами создавали — есть возможность проверить насколько хорошо справился k-means со своей задачей. В соответствии с вышеприведенной частью датасета переназначим найденные алгоритмом кластеры и сравним их с сгенерированными:
temp = result_df["предсказанные"].map() - result_df["группа"] temp.value_counts(normalize=True)Впечатляющее качество распознавания! К сожалению, в реальных данных этой информации как правило нет, а если есть, то это уже supervised learning и изначально нужно было решать задачу классификации, а не кластеризации. Проблему сложности восприятия табличных данных о кластерах принято решать графически при помощи dimensional reduction, что позволяет все фичи ужать до двух, x и y, и построить их на графике. Существует много алгоритмов dr, мы покажем один из самых популярных из-за своей красоты t-sne.
from matplotlib import pyplot as plt from sklearn.manifold import TSNE tsne_df = TSNE(n_components=2,perplexity=20).fit_transform(data) result_df["tsneX"] = tsne_df[:,0] result_df["tsneY"] = tsne_df[:,1] plt.scatter(result_df["tsneX"], result_df["tsneY"],s=2,) plt.savefig("blobs_gray.jpg",dpi=1200,transparent=True)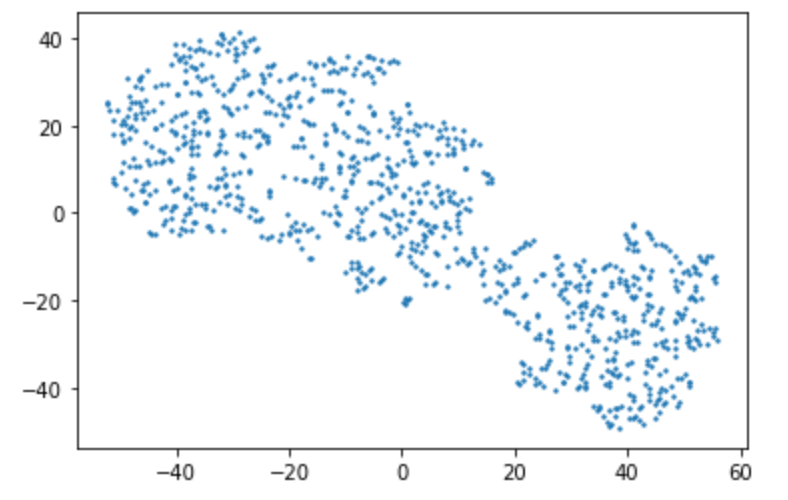
Как мы видим, пять фич сжались до двух, чтобы уместиться на плоскости. Кроме того, точки разделились на несколько различимых взглядом агломератов. Для проверки выделим точки справа по координатам и посмотрим какие из изначально созданных групп пользователей в него входят.
result_df[(result_df['tsneX']>15) & (result_df['tsneY']<5)]["группа"].value_counts()Name: группа, dtype: int64
Действительно, соответствует сгенерированному кластеру с кодом 0.
Если бы это были реальные данные, мы бы многое поняли о пользователях из этого графика — во первых группы пользователей действительно есть, их как минимум две, во вторых — все пользователи пользуются всеми ссылками, просто с разной интенсивностью, ведь кластеры связаны. Чтобы извлечь больше выводов из этого графика, можно добавить в него больше внешней информации. Проще всего изменению поддаются цвет точек, их фон и размер. Красить точки и фон лучше в категориальные фичи, размер же отведен для численных. В данном примере у нас нет никаких категориальных фич, кроме, собственно, кластеров к которым принадлежат точки. Покрасим точки на графике в цвета согласно известным нам заранее группам пользователей, для валидации. Этой информации у модели не было.
def colorer(row,column): if row[column] == 1: return "Green" if row[column] == 2: return "Brown" return "Magenta" result_df["цвет"] = result_df.apply(colorer,axis = 1,column = "группа") plt.scatter(result_df["tsneX"], result_df["tsneY"],s=2,c=list(result_df['цвет'])) plt.savefig("blobs_colored.jpg",dpi=1200,transparent=True)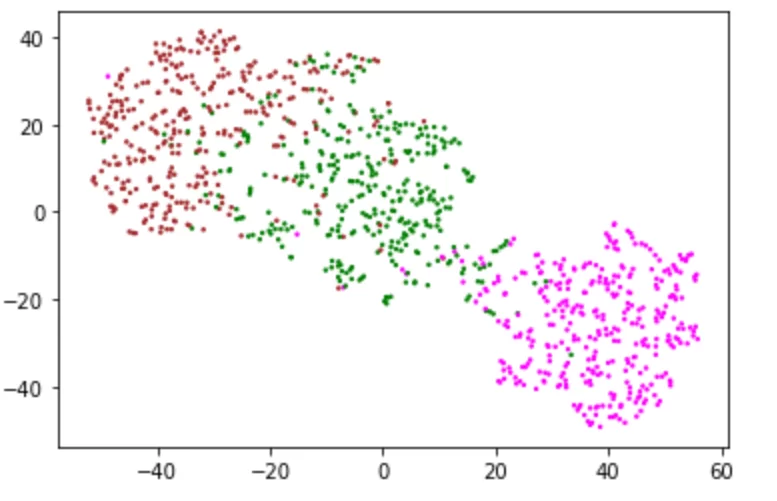
Метод t-sne сумел отделить фиолетовый кластер от двух других. В реальной ситуации в качестве цвета обычно выступает собранная помимо статистики переходов по ссылкам эвристика, например user agent их браузера, или их участие/неучастие в опросе, или проведенное на странице время. Бывает так, что кластеры видны плохо и выводы делать трудно. Для визуального определения помимо цвета можно использовать размер точек, делая более важные точки больше. При анализе поведения пользователей одной из самых важных для визуализации фич является активность.
Для примера сгенерируем ее при помощи случайных чисел, зависящих от номера кластера
result_df["активность"] = np.random.randint(1,10, len(result_df))*(result_df["группа"]+0.1) plt.scatter(result_df["tsneX"], result_df["tsneY"],s=list(result_df['активность']),c=list(result_df['цвет'])) plt.savefig("blobs_size.jpg",dpi=1200,transparent=True)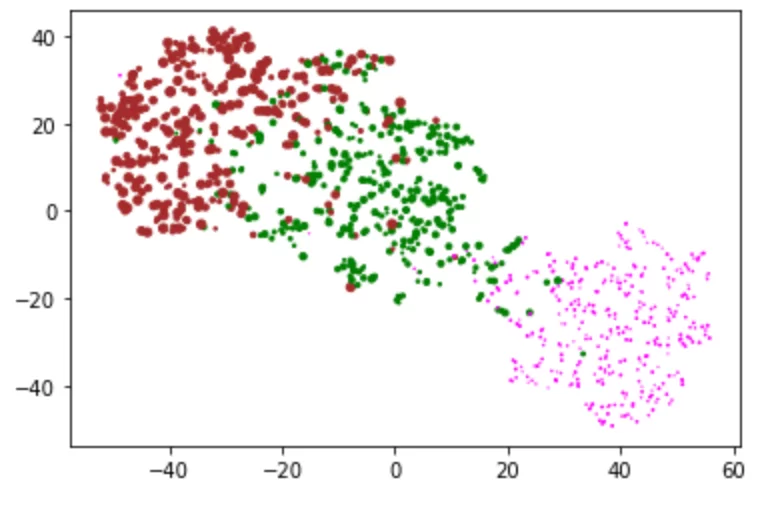
Видно, что в фиолетовый кластер входили самые неактивные пользователи, а в коричневый — самые активные. При этом случайные вбросы фиолетового цвета в зеленый стали менее видны, и это плюс, ведь нам важнее поведение активных пользователей, нежели чем неактивных.
Параметр размера также можно использовать для создания фона под картинкой, добавляя второй scatter на тот же график, с большим размером точки s и низкой прозрачностью alpha
result_df["фон"] = result_df.apply(colorer,axis = 1,column = "предсказанные") plt.scatter(result_df["tsneX"], result_df["tsneY"],s = 100, c=list(result_df['фон']) ,marker = "o",alpha = 0.05) plt.scatter(result_df["tsneX"], result_df["tsneY"],s=list(result_df['активность']),c=list(result_df['цвет'])) plt.savefig("blobs_background.jpg",dpi=1200,transparent=True)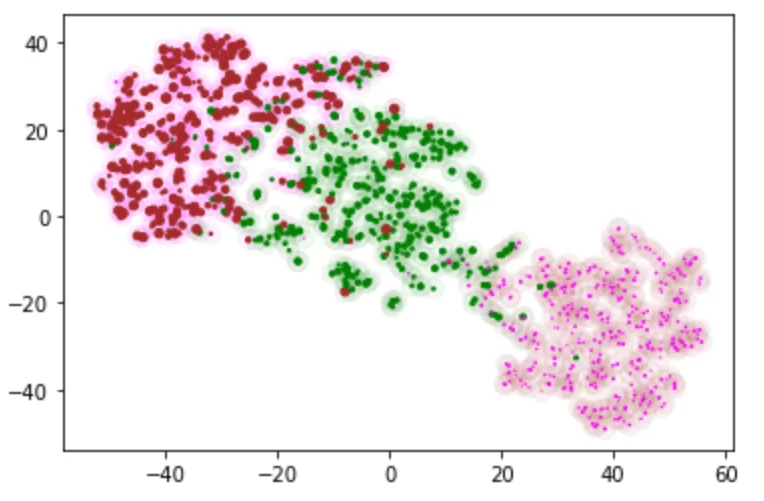
Использование фона очень полезно, если есть возможность эвристически распределить пользователей в другие группы, не связанные с поведением, например на фон можно поместить категорию размера города для каждой точки.
На этом этап построения графиков заканчивается, и начинается анализ результатов, включающий демонстрацию графика коллегам, поиск скрытых в нем инсайдов и многого другого, выходящего за рамки статьи. Совокупность вышеперечисленных подходов применима к любым неразмеченным данным, и была успешно использована для выявления интереса (и отсутствия интереса) к продуктам среди посетителей определенного сайта. Подобное исследование может дать пищу для размышлений в рамках выполнения обязанностей аналитиков, маркетологов и аудиторов.
Как сделать кластеризацию датасета python

МЕРОПРИЯТИЯ
YADRO X MOSCOW USER GROUP C++ MEETUP
Комментарии
Популярные По порядку
Не удалось загрузить комментарии.
ЛУЧШИЕ СТАТЬИ ПО ТЕМЕ
ООП на Python: концепции, принципы и примеры реализации
Программирование на Python допускает различные методологии, но в его основе лежит объектный подход, поэтому работать в стиле ООП на Python очень просто.
Пишем свою нейросеть: пошаговое руководство
Отличный гайд про нейросеть от теории к практике. Вы узнаете из каких элементов состоит ИНС, как она работает и как ее создать самому.
Программирование на Python: от новичка до профессионала
Пошаговая инструкция для всех, кто хочет изучить программирование на Python (или программирование вообще), но не знает, куда сделать первый шаг.