Поиск на сайте своими руками
Наверное, многие когда-нибудь задумывались, как сделать поиск на сайте? Безусловно, для крупных сайтов с большим количеством контента поиск является просто незаменимой вещью. В большинстве случаев пользователь, впервые посетив Ваш сайт в поисках чего-либо важного, не станет разбираться в навигационных панелях, выпадающих меню и прочих элементах навигации, а в спешке попытается найти что-нибудь похожее на поисковую строку. И если такой роскоши на сайте не окажется, либо он не справится с поисковым запросом, то посетитель просто закроет вкладку. Но статья не о значении поиска для сайта и не о психологии посетителей. Я расскажу, как реализовать небольшой алгоритм полнотекстового поиска, который, надеюсь, избавит начинающих разработчиков от головной боли.
У читателя может возникнуть вопрос: зачем писать все с нуля, если все уже давно написано? Да, у крупных поисковиков есть API, есть такие клевые проекты, как Sphinx и Apache Solr. Но у каждого из этих решений есть свои преимущества и недостатки. Пользуясь услугами поисковиков, типа Google и Яндекс, Вы получите множество плюшек, таких как мощный морфологический анализ, исправление опечаток и ошибок в запросе, распознавание неверной раскладки клавиатуры, однако без ложки дегтя тут не обойдется. Во первых, такой поиск не интегрируется в структуру сайта — он внешний, и Вы не сможете указать ему, какие данные наиболее важны, а какие не очень. Во вторых, содержимое сайта индексируется только с определенным интервалом, который зависит от выбранного поисковика, так что если на сайте что-нибудь обновится, придется дожидаться момента, когда эти изменения попадут в индекс и станут доступными в поиске. У Sphinx и Apache Solr дела с интеграцией и индексированием гораздо лучше, но не каждый хостинг позволит из запустить.
Ничто не мешает написать поисковый механизм самостоятельно. Предполагается, что сайт работает на PHP в связке с каким-нибудь сервером баз данных, например MySQL. Давайте сначала определимся, что требуется от поиска на сайте?
- Поиск с учетом языковой морфологии. Независимо от падежа, окончания и
других прелестей великого и могучего языка поиск должен находить то, что нужно
пользователю. Другими словами, «яблок», «яблока», «яблоки» — это формы одного и того
же слова «яблоко», что нужно учитывать в поисковом алгоритме. Одним из способов
достижения данной цели является приведение каждого слова поискового запроса и слов
содержимого сайта к базовой форме. - Возможность указать контекст поиска. То есть, возможность самостоятельно выбрать
контент сайта, в пределах которого будет работать поисковый алгоритм, а также определить
значимость для каждого из пределов. Например, рассмотрим интернет-магазин. Предполагается,
что поисковый запрос чаще всего будет содержать название искомой продукции, поэтому поиск по
названиям товара будет иметь наивысший приоритет. В качестве следующего приоритета можно
выбрать поиск по свойствам товаров, затем поиск по описанию. - Индексирование содержимого сайта. Представьте ситуацию: одновременно около 30 человек
выполняют поисковые запросы. Сервер принимает каждое соединение, управление потоком
передается интерпретатору PHP. При каждом запросе заново инициализируется поисковый
движок, заново перерывается содержимое сайта… Сложно сказать, сколько времени и
ресурсов потребуется, чтобы обработать все эти запросы. Именно для того, чтобы не
делать одну и ту же работу по сто раз, была придумана технология индексирования.
Индексирование выполняется только при изменении или добавлении содержимого сайта,
а поиск выполняется уже по индексу, а не по содержимому. - Механизм ранжирования. Ранжирование результатов поиска — это сортировка результатов поиска, выполняемая на основе оценки значимости найденных данных. Например, в каком-нибудь блоге выполняется поисковый запрос «космос». Данное слово содержится в двух статьях: в первой 16 раз, во второй — 5 раз. Вероятнее всего, первая статья будет иметь большее значение для инициатора поиска. Также каждой разновидности содержимого сайта при индексировании задается определенный коэффициент, который будет влиять на его позиции в поисковой выдаче.
- морфологический анализатор,
- алгоритм ранжирования,
- алгоритм индексирования,
- алгоритм поиска.
В конце статьи будет показан пример реализации поиска на примере простого интернет-магазина. Тем, кому лень все это изучать и просто нужен готовый поисковик, можно смело забирать движок из репозитория GitHub FireWind.
Принцип работы
- содержимое сайта индексируется,
- пользователь присылает запрос,
- из запроса исключаются служебные части речи,
- получившаяся строка разбивается на массив слов, переведенных в базовую форму,
- поиск каждого слова полученного массива осуществляется в индексе,
- результаты поиска ранжируются, сортируются и отдаются пользователю.
Подготовка
Задача поставлена, теперь можно перейти к делу. Я использую Linux в качестве рабочей ОС, однако постараюсь не использовать ее экзотических возможностей, чтобы любители Windows смогли «собрать» поисковый движок по аналогии. Все, что Вам нужно — это знание основ PHP и умение обращаться с MySQL. Поехали!
Наш проект будет состоять из ядра, где будут собраны все жизненно необходимые функции, а также модуля морфологического анализа и обработки текста. Для начала создадим корневую папку проекта firewind, а в ней создадим файл core.php — он и будет ядром.
$ mkdir firewind $ cd firewind $ touch core.php Теперь вооружаемся своим любимым текстовым редактором и подготавливаем каркас:
Тут мы создали основной класс, который можно будет использовать на Ваших сайтах. На этом подготовительная часть заканчивается, пора двигаться дальше.
Морфологический анализатор
Русский язык — довольно сложная штука, которая радует своим разнообразием и шокирует иностранцев конструкциями, типа «да нет, наверное». Научить машину понимать его, да и любой другой язык, — довольно непростая задача. Наиболее успешны в этом плане поисковые компании, типа Google и Яндекс, которые постоянно улучшают свои алгоритмы и держат их в секрете. Придется нам сделать что-то свое, попроще. К счастью, колесо изобретать не придется — все уже сделано за нас. Встречайте, phpMorphy — морфологический анализатор, поддерживающий русский, английский и немецкий языки. Более подробную информацию можно получить тут, однако нас интересуют только две его возможности: лемматизация, то есть получение базовой формы слова, и получение грамматической информации о слове (род, число, падеж, часть речи и т.д.).
Нужна библиотека и словарь для нее. Все это добро можно найти тут. Библиотека находится в одноименной папке «phpmorphy», словари расположены в «phpmorphy-dictionaries». Скачиваем последние версии в корневую папку проекта и распаковываем:
# Распаковываем библиотеку $ unzip phpmorphy-0.3.7.zip $ mv phpmorphy-0.3.7 phpmorphy # Распаковываем словарь в phpmorphy/dicts $ unzip morphy-0.3.x-ru_RU-withjo-utf-8.zip -d phpmorphy/dicts/ # Удаляем исходные архивы $ rm phpmorphy-0.3.7.zip morphy-0.3.x-ru_RU-withjo-utf-8.zip Отлично! Библиотека готова к использованию. Пришло время написать «оболочку», которая абстрагирует работу с phpMorphy. Для этого создадим еще один файл morphyus.php в корневой директории:
phpmorphy = new phpMorphy( $directory, $language, $options ); > /** * Разбивает текст на массив слов * * @param content Исходный текст для выделения слов * @param filter Активирует фильтрацию HTML-тегов и сущностей * @return Результирующий массив */ public function get_words( $content, $filter=true ) < // Фильтрация HTML-тегов и HTML-сущностей // if ( $filter ) < $content = strip_tags( $content ); $content = preg_replace( $this->regexp_entity, ' ', $content ); > // Перевод в верхний регистр // $content = mb_strtoupper( $content, 'UTF-8' ); // Замена ё на е // $content = str_ireplace( 'Ё', 'Е', $content ); // Выделение слов из контекста // preg_match_all( $this->regexp_word, $content, $words_src ); return $words_src[ 1 ]; > /** * Находит леммы слова * * @param word Исходное слово * @param Массив возможных лемм слова, либо false */ public function lemmatize( $word ) < // Получение базовой формы слова // $lemmas = $this->phpmorphy->lemmatize( $word ); return $lemmas; > > ?> Пока реализовано только два метода. get_words разбивает текст на массив слов, фильтруя при этом HTML-теги и сущности типа » «. Метод lemmatize возвращает массив лемм слова, либо false, если таковых не нашлось.
Механизм ранжирования на уровне морфологии
Давайте остановимся на такой единице языка, как предложение. Наиболее важной частью предложения является основа в виде подлежащего и/или сказуемого. Чаще всего подлежащее выражается существительным, а сказуемое глаголом. Второстепенные члены в основном употребляются для уточнения смысла основы. В разных предложениях одни и те же части речи порой имеют совершенно разное значение, и наиболее точно оценить это значение в контексте текста сегодня может только человек. Однако программно оценить значение какого-либо слова все-таки можно, хоть и не так точно. При этом алгоритм ранжирования должен опираться на так называемый профиль текста, который определяется его автором. Профиль представляет из себя ассоциативный массив, ключами которого являются части речи, а значениями соответственно ранг (или вес) каждой из них. Пример профиля я покажу в заключении, а пока попробуем перевести эти размышления на язык PHP, добавив еще один метод к классу morphyus:
word Исходное слово * @param profile Профиль текста * @return Оценка значимости от 0 до 5 */ public function weigh( $word, $profile=false ) < // Попытка определения части речи // $partsOfSpeech = $this->phpmorphy->getPartOfSpeech( $word ); // Профиль по умолчанию // if ( !$profile ) < $profile = [ // Служебные части речи // 'ПРЕДЛ' =>0, 'СОЮЗ' => 0, 'МЕЖД' => 0, 'ВВОДН' => 0, 'ЧАСТ' => 0, 'МС' => 0, // Наиболее значимые части речи // 'С' => 5, 'Г' => 5, 'П' => 3, 'Н' => 3, // Остальные части речи // 'DEFAULT' => 1 ]; > // Если не удалось определить возможные части речи // if ( !$partsOfSpeech ) < return $profile[ 'DEFAULT' ]; >// Определение ранга // for ( $i = 0; $i < count( $partsOfSpeech ); $i++ ) < if ( isset( $profile[ $partsOfSpeech[ $i ] ] ) ) < $range[] = $profile[ $partsOfSpeech[ $i ] ]; >else < $range[] = $profile[ 'DEFAULT' ]; >> return max( $range ); > > ?> Индексирование содержимого сайта
Как уже говорилось выше, индексирование заметно ускоряет выполнение поискового запроса, так как поисковому движку не нужно обрабатывать контент каждый раз заново — поиск выполняется по индексу. Но что же все-таки происходит при индексировании? Если по порядку, то:
- Сначала из текста формируется массив слов, и делается это с помощью метода get_words.
- Согласно профилю, из текста отбрасываются незначимые части речи.
- Значимые оцениваются по пятибальной шкале, с помощью метода weigh.
- Для каждого сова выполняется поиск лемм, иначе говоря базовых форм.
- Рассчитывается количество повторений каждого слова и суммарный ранг.
- Все данные записываются в объект и в виде JSON записываются в базу данных.
В результате получается объект следующего формата:
< "range" : "", "words" : [ // Одно из слов // < "source" : "", "range" : "", "count" : "", "weight" : "", "basic" : [ // Варианты лемм слова // ] > ] > Пишем инициализатор и первый метод ядра поискового движка:
morphyus = new morphyus; > /** * Выполняет индексирование текста * * @param content Текст для индексирования * @param [range] Коэффициент значимости индексируемых данных * @return Результат индексирования */ public function make_index( $content, $range=1 ) < $index = new stdClass; $index->range = $range; $index->words = []; // Выделение слов из текста // $words = $this->morphyus->get_words( $content ); foreach ( $words as $word ) < // Оценка значимости слова // $weight = $this->morphyus->weigh( $word ); if ( $weight > 0 ) < // Количество слов в индексе // $length = count( $index->words ); // Проверка существования исходного слова в индексе // for ( $i = 0; $i < $length; $i++ ) < if ( $index->words[ $i ]->source === $word ) < // Исходное слово уже есть в индексе // $index->words[ $i ]->count++; $index->words[ $i ]->range = $range * $index->words[ $i ]->count * $index->words[ $i ]->weight; // Обработка следующего слова // continue 2; > > // Если исходного слова еще нет в индексе // $lemma = $this->morphyus->lemmatize( $word ); if ( $lemma ) < // Проверка наличия лемм в индексе // for ( $i = 0; $i < $length; $i++ ) < // Если у сравниваемого слова есть леммы // if ( $index->words[ $i ]->basic ) < $difference = count( array_diff( $lemma, $index->words[ $i ]->basic ) ); // Если сравниваемое слово имеет менее двух отличных лемм // if ( $difference === 0 ) < $index->words[ $i ]->count++; $index->words[ $i ]->range = $range * $index->words[ $i ]->count * $index->words[ $i ]->weight; // Обработка следующего слова // continue 2; > > > > // Если в индексе нет ни лемм, ни исходного слова, // // значит пора добавить его // $node = new stdClass; $node->source = $word; $node->count = 1; $node->range = $range * $weight; $node->weight = $weight; $node->basic = $lemma; $index->words[] = $node; > > return $index; > > ?> Теперь при добавлении или изменении данных в таблицах достаточно просто вызвать данную функцию, чтобы проиндексировать их, но это не обязательно: индексирование может быть и отложенным. Первым аргументом метода make_index является исходный текст, вторым — коэффициент значимости индексируемых данных. Ранг каждого слова, кстати, расчитывается по формуле:
* * ; // В коде это выглядит так: // $index->words[ $i ]->range = $range * $index->words[ $i ]->count * $index->words[ $i ]->weight; ?> Хранение индексированных данных
Очевидно, что индекс нужно где-нибудь хранить, да еще и привязать к исходным данным. Наиболее подходящим местом для них будет база данных. Если индексируется содержимое файлов, то можно создать отдельную таблицу в базе данных, которая будет содержать индекс название каждого файла, а для содержимого, которое уже хранится в базе, можно добавить еще одно поле типа в структуру таблиц. Такой подход позволит разделять типы содержимого при поиске, например, названия и описание статей в случае блога.
Нерешенным остался лишь вопрос формата индексированного содержимого, ведь make_index возвращает объект, и так просто в базу данных или файл его не запишешь. Можно использовать JSON и хранить его в полях типа LONGTEXT, можно BSON или CBOR, используя тип данных LONGBLOB. Два последних формата позволяют представлять данные в более компактном виде, чем первый.
Как говорится, «хозяин — барин», так-что решать, где и как все будет храниться, Вам.
Benchmark
Давайте проверим, что у нас получилось. Я взял текст своей любимой статьи «Темная материя интернета», а именно содержимое узла #content html_format и сохранил его в отдельный файл.
make_index( $source ); // Засекаем время конца // $finish_time = microtime( true ); echo "Indexing finished: $finish_time\n"; // Результаты // $total_time = $finish_time - $begin_time; echo "Total time: $total_time\n"; ?> На моей машине с конфигурацией:
CPU: Intel Core i7-4510U @ 2.00GHz, 4M Cache
RAM: 2×4096 Mb
OS: Ubuntu 14.04.1 LTS, x64
PHP: 5.5.9-1ubuntu4.5
Индексирование заняло около секунды:
$ php benchmark.php Indexing started: 1417343592.3094 Indexing finished: 1417343593.5604 Total time: 1.2510349750519 Думаю, вполне неплохой результат.
Реализация поиска
Остался последний и самый главный метод, метод поиска. В качестве первого аргумента метод принимает индекс поискового запроса, в качестве второго — индекс содержимого, в котором выполняется поиск. В результате выполнения возвращается суммарный ранг, рассчитанный на основе ранга найденных слов, либо 0, если ничего не нашлось. Это позволит сортировать поисковую выдачу.
target Искомые данные * @param source Данные, в которых выполняется поиск * @return Суммарный ранг на основе найденных данных */ public function search( $target, $index ) < $total_range = 0; // Перебор слов запроса // foreach ( $target->words as $target_word ) < // Перебор слов индекса // foreach ( $index->words as $index_word ) < if ( $index_word->source === $target_word->source ) < $total_range += $index_word->range; > else if ( $index_word->basic && $target_word->basic ) < // Если у искомого и индексированного слов есть леммы // $index_count = count( $index_word ->basic ); $target_count = count( $target_word ->basic ); for ( $i = 0; $i < $target_count; $i++ ) < for ( $j = 0; $j < $index_count; $j++ ) < if ( $index_word->basic[ $j ] === $target_word->basic[ $i ] ) < $total_range += $index_word->range; continue 2; > > > > > > return $total_range; > > ?> Все! Поисковый движок готов к использованию. Но есть одно но… На самом деле это не джин-волшебник, и просто закинув его на свой сайт Вы не получите ничего. Его нужно интегрировать, причем этот процесс во многом зависит от архитектуры Вашего сайта. Рассмотрим этот процесс на примере небольшого интернет магазина.
Реализация поиска на примере интернет-магазина
Допустим, информация о продаваемой продукции хранится в таблице production:
CREATE TABLE `production` ( `uid` INT NOT NULL AUTO_INCREMENT, -- Уникальный идентификатор `name` VARCHAR(45) NOT NULL, -- Название продукта `manufacturer` VARCHAR(45) NOT NULL, -- Производитель `price` INT NOT NULL, -- Стоимость продукта `keywords` TEXT NULL, -- Индекс ключевых слов PRIMARY KEY ( `uid` ) ); SHOW COLUMNS FROM `production`; +--------------+-------------+------+-----+---------+-------+ | Field | Type | Null | Key | Default | Extra | +--------------+-------------+------+-----+---------+-------+ | uid | int(11) | NO | PRI | NULL | | | name | varchar(45) | NO | | NULL | | | manufacturer | varchar(45) | NO | | NULL | | | price | int(11) | NO | | NULL | | | keywords | text | YES | | NULL | | +--------------+-------------+------+-----+---------+-------+ А описание в таблице description:
CREATE TABLE `description` ( `uid` INT NOT NULL AUTO_INCREMENT, -- Уникальный идентификатор `fid` INT NOT NULL, -- Внешний ключ для привязки описания к продукту `description` LONGTEXT NOT NULL, -- Само описание `index` TEXT NULL, -- Индексированное описание PRIMARY KEY ( `uid` ) ); SHOW COLUMNS FROM `description`; +-------------+----------+------+-----+---------+-------+ | Field | Type | Null | Key | Default | Extra | +-------------+----------+------+-----+---------+-------+ | uid | int(11) | NO | PRI | NULL | | | fid | int(11) | NO | | NULL | | | description | longtext | NO | | NULL | | | index | text | YES | | NULL | | +-------------+----------+------+-----+---------+-------+ Поле production.keywords будет содержать индекс ключевых слов продукта, description.index будет содержать индексированное описание. И все это будут храниться в формате JSON.
Вот пример функции добавления нового продукта:
connect_error ) < die( 'Cannot connect to database.' ); >$connection->set_charset( 'UTF8' ); function add_product( $name, $manufacturer, $price, $description, $keywords ) < global $firewind, $connection; // Индексирование описания продукта // $description_index = $firewind->make_index( $description ); $description_index = json_encode( $description_index ); // Индексирование ключевых слов // $keywords_index = $firewind->make_index( $keywords, 2 ); $keywords_index = json_encode( $keywords_index ); // Подготовка запросов // $production_query = $connection->prepare( "INSERT INTO `production` ( `name`, `manufacturer`, `price`, `keywords` ) VALUES ( ?, ?, ?, ? )" ); $description_query = $connection->prepare( "INSERT INTO `description` ( `fid`, `description`, `index` ) VALUES ( LAST_INSERT_ID(), ?, ? )" ); if ( !$production_query || !$description_query ) < die( "Cannot prepare requests!\n" ); >if ( // Биндинг параметров // $production_query -> bind_param( 'ssis', $name, $manufacturer, $price, $keywords_index ) && $description_query -> bind_param( 'ss', $description, $description_index ) && // Выполнение запросов // $production_query -> execute() && $description_query -> execute() ) < // Если запросы выполнились успешно // echo( "Product successfully added!\n" ); // Завершение запросов // $production_query ->close(); $description_query -> close(); return true; > else < die( "An error occurred while executing query. \n" ); >> ?> Здесь поисковый механизм был интегрирован в функцию добавления нового продукта магазина. А теперь обработчик поисковых запросов:
connect_error ) < die( 'Cannot connect to database.' ); >$connection->set_charset( 'UTF8' ); // Поисковый запрос // $query = isset( $_GET[ 'query' ] ) ? trim( $_GET[ 'query' ] ) : false; if ( $query ) < // Обработка поискового запроса // $query_index = $firewind->make_index( $query ); // Получение данных // $production = $connection->query(" SELECT p.`uid`, p.`name`, p.`keywords`, d.`index` FROM `production` p, `description` d WHERE p.`uid` = d.`uid` "); if ( !$production ) < die( "Cannot get production info.\n" ); >// Выполнение поиска // while ( $product = $production->fetch_assoc() ) < // Распаковка индекса // $keywords = json_decode( $product[ 'keywords' ] ); $index = json_decode( $product[ 'index' ] ); $range = $firewind->search( $query_index, $keywords ); $range += $firewind->search( $query_index, $index ); if ( $range > 0 ) < $result[ $product[ 'uid' ] ] = $range; >> // Если что-нибудь нашлось // if ( isset( $result ) ) < // Сортировка по убыванию // arsort( $result ); // Вывод результатов // $i = 1; foreach ( $result as $uid =>$range ) < printf( "#%d. Found product with id %d and range %d.\n", $i++, $uid, $range ); >> else < echo( "Sorry, no results found.\n" ); >> else < echo( "Query cannot be empty. Try again.\n" ); >?> Данный сценарий принимает поисковый запрос в виде GET-параметра query и выполняет поиск. В результате выводятся найденные продукты магазина.
Заключение
В статье был описан один из вариантов реализации поиска для сайта. Это самая первая его версия, поэтому буду только рад узнать Ваши замечания, мнения и пожелания. Присоединяйтесь к моему проекту на Github: https://github.com/axilirator/firewind. В планах добавить туда еще кучу всяких возможностей, вроде кэширования поисковых запросов, подсказок при вводе поискового запроса и алгоритма побуквенного сравнения, который поможет бороться с опечатками.
Всем спасибо за внимание, ну и с днем информационной безопасности!
Как сделать поиск по сайту?
В некоторых случаях найти определенную информацию на сайте помогает поиск по сайту. В uKit предлагается два виджета поиска по сайту: Поиск Яндекс и Поиск Google.
Примечание:
Перед размещением виджетов поиска не забудьте добавить ваш сайт в Яндекс.Вебмастер и Google Search Console.
Поиск Яндекс
1. Разместите виджет «Поиск Яндекс» в нужном месте страницы вашего сайта
2. Перейдите на страницу создания поиска, нажмите «Добавить сайты и исключения» в разделе «Области поиска» и вставьте адрес вашего сайта в поле «Сайты»
3. Далее, выполняйте все шаги, следуя инструкциям. На пятом шаге скопируйте ID поиска из предложенного кода и вставьте его в поле «ID поиска»:
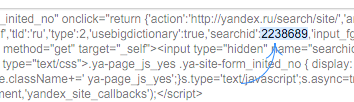
Или скопируйте ID из адресной строки:
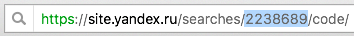
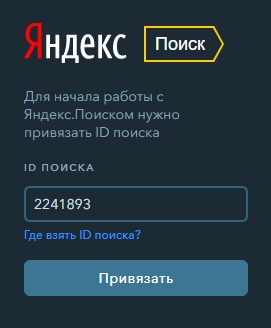
4. Вставьте полученный ID в поле для привязки поиска:
Поиск Google
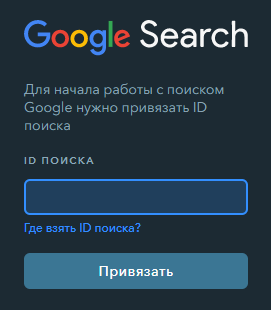
1. Разместите виджет «Поиск Google» в нужном месте страницы вашего сайта
2. Перейдите на страницу создания поиска, нажмите «Добавить сайты и вставьте адрес вашего сайта в поле «Сайты, на которых выполняется поиск:»
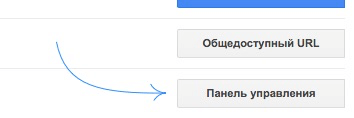
3. Нажмите кнопку «Создать» и на появившейся странице кликните на кнопку «Панель управления»:
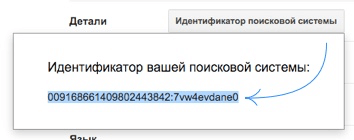
4. В разделе «Детали» скопируйте идентификатор Вашей поисковой системы:
5. Вставьте полученный ID в поле для привязки поиска:
Важно:
Поиск по сайту осуществляется только по проиндексированным страницам, которые были добавлены в поисковые системы. Новые страницы могут какое-то время отсутствовать в поиске по сайту.
Попробуйте прямо сейчас!
Как сделать рабочий поиск по сайту html
Прежде чем перейти к алгоритму. данный поиск стоит у нас на сайте, см. сверху. Единственное отличие — получаем название страницы и выводим её. Адоптировано под нашу структуру сайта. Название страницы хранится в переменной $title = «»;
$new = my_strtolower( @file_get_contents(путь до файла)); //получаем файл в строку.
preg_match(‘/\$title(.+?);/i’, $new, $ttle); //получаем данные внутри переменной
$titles = str_replace(array(‘=’,'»‘,»‘»), », $ttle[1]) ;//удаляем равно и кавычки.
if (substr_count( my_strtolower($titles), my_strtolower ( $poisk ))) //проверяем на совпадение в заголовке искомого слова $poisk и если совпадение найдено выделяем тегом «mark».
Алгоритм поиска по сайту — нужно взять контент страницы,(либо ту строку базы данных, которая отвечает за контент) и проверить на совпадение с искомым словом, для этого будем использовать функцию substr_count и выдать на какой странице данное совпадение находится.
И далее в цикле проверить все файлы или строки в базе на совпадение!
Поиск по контенту сайта -> база данных
Для данного примера есть архив со скриптом.
04.05.2020 Друзья!
Я уже давно не занимался базами данных, поэтому, никак проверить не смогу работоспособность данного скрипта!
НО! Схематично могу набросать, как бы я делал поиск по базе данных сайта.
Берем скрипт вывода из базы данных
Все что внутри цикла while удаляем и туда вставляем:
1). $row[‘CONTENT’] — столбец, отвечающий за контент
2). $row[‘url’] — столбец, отвечающий за ссылку
3). $row[‘title’] — столбец, отвечающий за заголовок
Ниже скрипта располагаем форму для отправки запроса на поиск оп базе данных:
В самом верху страницы располагаем функцию собственную функцию strtolowermy_strtolower
Следующей строкой получаем данные из формы :
if($_POST[‘poisk’])< $poisk = strip_tags ( $_POST['poisk'] );>
Пропускам данные через my_strtolower:
$poisk = my_strtolower( $poisk );
Скачать скрипт поиска по базе данных
Поиск по контенту сайта -> файлы DW — search 1.2
04.05.2020 Для данного параграфа у нас есть :
Скачать со страницы скриптов
Если мы говорим о поиске по контенту на сайте, который сделан на файлах, то первое с чем мы сталкиваемся, против базы данных, как получить все ссылки на все файлы!?
Другими словами, где у вас есть все ссылки вашего сайта!? Предположим, что все ваши ссылки есть в карте sitemap.XML — нам нужно извлечь все ссылки из данного файла, а потом в цикле проверить наличие искомого слова.
Да! И функцию my_strtolower можете заменить на обычную strtolower(если она у вас работает)
Теперь не нужно вставлять домен, он будет автоматически передаваться в переменную!
$domen = $_SERVER[«HTTP_X_FORWARDED_PROTO»].’://’.$_SERVER[«HTTP_HOST»] ;
1). Получаем из карты все содержимое в строку с помощью file_get_contents
$ALL_pages = file_get_contents(‘https://dwweb.ru/sitemap.xml’);
2). Получаем в массив все ссылки из тегов loc с помощью preg_match_all :
preg_match_all(«#
3). Поскольку первой ячейкой у нас автоматически всегда будет домен, т.е. главная — нам эту ячейку надо удалить!
$fruit = array_shift($url[1]);
4). Получим путь до корневой переменная $home(она нам потом понадобится.)
+ Получим в переменную $poisk от правленный поисковый запрос.
+ все буквы приведем к нижнему регистру my_strtolower
$poisk = my_strtolower( $poisk );
5). Создадим условие — будем проверять существование файла + путь заменим ранее полученный домен, на путь на сервере
if( file_exists( str_replace( $domen , $home , $ALL_PAGES[$i]) ) )
Теперь весь контент страницы полученный в цикле через file_get_contents переведем в нижний регистр — my_strtolower и внутри получим путь на сревре заменив домен на $home
Далее собственно поиск искомого слова в контенте substr_count
+ если что-то найдено, то создаем счетчик +1($line_count)
+ заносим в переменную $rezult адрес страницы, где это было найдено.
$new = my_strtolower( file_get_contents( str_replace( $domen , $home , $ALL_PAGES[$i]) ) );
if (substr_count($new, $poisk))
7). Проверяем если счетчик существует, то выводим на экран переменную $vivod_info
if($line_count)($vivod_info)
8). и далее если отправлен
$rezult = ‘Отправлен пустой запрос’;
Далее особо ничего интересного. форма + вывод полученных данных.
Как сделать аналог поиска ctrl + f хрома для сайта?

Сделал поиск на сайте, но еще нужна функция чтобы можно было переключаться между найденными словами. Как сделать аналог поиска ctrl + f хрома для сайта? Код:
Отслеживать
задан 25 мар 2019 в 21:46
Андрей Повх Андрей Повх
944 7 7 серебряных знаков 22 22 бронзовых знака
зачем eval если есть конструктор принимающий строку?
25 мар 2019 в 22:15
При таком подходе реализации поиска у вас пропадут все события на странице.
26 мар 2019 в 4:23
26 мар 2019 в 21:13
2 ответа 2
Сортировка: Сброс на вариант по умолчанию
Данный код это то, что я искал:
function searchAndHighlight(searchTerm, selector) < if (searchTerm) < //var wholeWordOnly = new RegExp("\\g"+searchTerm+"\\g","ig"); //matches whole word only //var anyCharacter = new RegExp("\\g["+searchTerm+"]\\g","ig"); //matches any word with any of search chars characters var selector = selector || "#realTimeContents"; //use body as selector if none provided var searchTermRegEx = new RegExp(searchTerm, "ig"); var matches = $(selector).text().match(searchTermRegEx); if (matches != null && matches.length >0) < $('.highlighted').removeClass('highlighted'); //Remove old search highlights //Remove the previous matches $span = $('#realTimeContents span'); $span.replaceWith($span.html()); if (searchTerm === "&") < searchTerm = "&"; searchTermRegEx = new RegExp(searchTerm, "ig"); >$(selector).html($(selector).html().replace(searchTermRegEx, "" + searchTerm + "")); $('.match:first').addClass('highlighted'); var i = 0; $('.next_h').off('click').on('click', function () < i++; if (i >= $('.match').length) i = 0; $('.match').removeClass('highlighted'); $('.match').eq(i).addClass('highlighted'); $('.ui-mobile-viewport').animate(< scrollTop: $('.match').eq(i).offset().top >, 300); >); $('.previous_h').off('click').on('click', function () < i--; if (i < 0) i = $('.match').length - 1; $('.match').removeClass('highlighted'); $('.match').eq(i).addClass('highlighted'); $('.ui-mobile-viewport').animate(< scrollTop: $('.match').eq(i).offset().top >, 300); >); if ($('.highlighted:first').length) < //if match found, scroll to where the first one appears $(window).scrollTop($('.highlighted:first').position().top); >return true; > > return false; > $(document).on('click', '.searchButtonClickText_h', function (event) < $(".highlighted").removeClass("highlighted").removeClass("match"); if (!searchAndHighlight($('.textSearchvalue_h').val())) < alert("No results found"); >>); .highlighted < background-color:yellow; >.highlight < background-color: #fff34d; -moz-border-radius: 5px; /* FF1+ */ -webkit-border-radius: 5px; /* Saf3-4 */ border-radius: 5px; /* Opera 10.5, IE 9, Saf5, Chrome */ -moz-box-shadow: 0 1px 4px rgba(0, 0, 0, 0.7); /* FF3.5+ */ -webkit-box-shadow: 0 1px 4px rgba(0, 0, 0, 0.7); /* Saf3.0+, Chrome */ box-shadow: 0 1px 4px rgba(0, 0, 0, 0.7); /* Opera 10.5+, IE 9.0 */ >.highlightSearchNextPreviousLorem ipsum dolor sit amet, consectetur adipiscing elit, sed do eiusmod tempor incididunt ut labore et dolore magna aliqua. Ut enim ad minim veniam, quis nostrud exercitation ullamco laboris nisi ut aliquip ex ea commodo consequat. Duis aute irure dolor in reprehenderit in voluptate velit esse cillumОтслеживать
ответ дан 26 мар 2019 в 20:46
Андрей Повх Андрей Повх
944 7 7 серебряных знаков 22 22 бронзовых знакаМне кажется странным — почему вы меняете реальный контент страницы !?
Я бы реализовал это по другому:
- можно найти все вхождения строки поиска в nodeType === 3
- определить границы вхождений с помощью API Range
- создать маску, которая перекрывает вхождения и не нарушает целостность реальной страницы
Конечно полная реализация заставит попотеть, но приведу рабочий пример.
Здесь не все реализовано, например нет установки свойств шрифта( увидите это при поиске в заголовке h1 ) и т.п.Запустите сниппет — должно быть как на этой картинке.
var input = document.getElementById('input'); document.getElementById('find').addEventListener('click', inputTextTrim); // текущий текст поиска var inputText; var map = < /* inputText: массив_или_различные_опции */ >; function inputTextTrim() < var t = input.value.trim().toLowerCase(); if (t && t !== inputText) < // для примера все удалю, но в реале такой объект можно использовать как кеш поиска if (map[inputText]) < while (map[inputText].length) < document.body.removeChild(map[inputText].pop()); >map[inputText] = null; delete map[inputText]; > inputText = t; console.log('find', inputText); findText(document.body /* root-element */); > > // Обход элементов function findText(el) < [].forEach.call(el.childNodes, i => < // node 3 - текс if (i.nodeType === 3) < findTextNode(i); >else if (i.nodeType === 1) < findText(i); >>); > // Поиск вхождения function findTextNode(tn) < var t = tn.data.toLowerCase(), i = 0; // вхождений в строке может быть множество while ((i = t.indexOf(inputText, i)) !== -1) < selectText(tn, i++, inputText.length); >> // Поиск позиции function selectText(tn, i, l) < console.log(tn, i, l); // копируем для наложения сверху var copy = tn.data.substring(i, i + l); if (!map[inputText]) < map[inputText] = []; >// определяем позицию и создаем элемент // выбираем наш кусок текста var range = document.createRange(); range.setStart(tn, i); range.setEnd(tn, i + l); // определяем размеры и позиции var rect = range.getBoundingClientRect(); createFindText(inputText, copy, rect.x, rect.y, rect.width, rect.height); > // Создание элемента function createFindText(iText, text, posX, posY, width, height) < var s = document.createElement('span'); s.textContent = text; s.style.backgroundColor = '#FFEB3B'; s.style.color = 'black'; s.style.position = 'absolute'; s.style.left = posX + 'px'; s.style.top = posY + 'px'; s.style.width = width + 'px'; s.style.height = height + 'px'; // для последующего удаления map[iText].push(s); document.body.appendChild(s); >
