Как парсить поисковые запросы в яндексе
Дата публикации: 18 января 2022
Время чтения: 10 минут
Анализ ключевых слов: как узнать статистику запросов в Яндексе и Google
Сбор семантического ядра — важный этап поисковой оптимизации. От релевантности и частотности ключевых фраз будет зависеть то, какое место ваш сайт или отдельная страница займут в выдаче и насколько быстро выйдут в топ. Как посмотреть статистику запросов и какие сервисы в этом помогут, читайте в статье.
Редакция iConText Group,
независимой группы digital-компаний
Почему нужно знать число показов поисковых запросов
Один из важных факторов продвижения сайтов, лендингов, аккаунтов в соцсетях и других сервисов — насколько легко пользователи находят их по запросам в поиске. А для этого важно грамотно оптимизировать ресурсы.
В каких случаях нужна оптимизация:
-
Создание сайта. Чтобы ресурс корректно индексировался роботами поисковиков, нужно оптимизировать его страницы под релевантные и наиболее распространенные запросы.
Где посмотреть статистику поисковых запросов
Чтобы посмотреть, как часто пользователи вбивают запрос в поиске, можно использовать инструмент Яндекс.Вордстат.
- сбор основы семантического ядра;
- ранжирование популярных запросов по устройствам и регионам;
- выявление сезонности.

В правом столбце представлены запросы, похожие на введенный и сопутствующие ему. Это те фразы, которые пользователи чаще всего ищут вместе с вашей. Словосочетания из правого столбца помогут обогатить семантическое ядро.
Если хотите посмотреть информацию по дословной формулировке, без склонений и добавления других слов, используйте соответствующий оператор — кавычки. Например, «медийная реклама».

Для уточнения запросов можно использовать и другие операторы. Например, !, +, () и др. Подробнее о том, что они обозначают и как их правильно применять, написано в справке.
В Вордстате есть три опции: возможность посмотреть данные по отдельным словам, регионам или историю запросов целиком.
-
По словам. Отображает число показов запроса и похожих на него фраз. Причем вы можете выбрать конкретный регион (внизу под полем для ввода).

- История запросов. Отображает динамику показов по введенной фразе. Причем на странице представлен и график, и таблица, где указаны точные данные по месяцам.

Обратите внимание: цифры, представленные в сервисе, не фактические, а прогнозные. На основе данных, собранных за предыдущие периоды, они отображают, сколько раз запрос может быть показан в месяц.
Для удобства используйте плагины Yandex Wordstat Assistant и Yandex Wordstat Helper. Они позволяют существенно ускорить ручной сбор запросов с помощью Вордстата.
Здесь есть своя панель для вебмастеров — Search Console. Сервис бесплатный, с достаточно широким функционалом. Он позволяет изучать статистику поисковых запросов, оценивать их эффективность, создавать группы объявлений.
Здесь стоит выделить несколько инструментов: планировщик ключевых слов, Google Trends и статистика запросов Google Analytics. Расскажем по порядку о каждом.
1. Планировщик ключевых слов
Чтобы работать с сервисом, потребуется создать аккаунт и зарегистрировать рекламный кабинет в Google Ads. Далее откройте страницу Google Рекламы, перейдите на вкладку «Инструменты» и затем — «Планировщик ключевых слов».

Далее откройте раздел «Посмотрите количество запросов и прогнозы». В появившемся окне введите одну или несколько фраз или загрузите файл со списком.

В результате получите следующие данные: показы, число кликов, стоимость, средняя позиция, средняя цена за клик, CTR. Google не отображает частоту запросов, а адаптирует показатели под настраиваемую рекламную кампанию. Основная цель — показать пользователю, какой может быть конверсия при определенной цене клика, если он планирует продвигаться по искомой фразе.
2. Google Trends
Это аналитический инструмент для оценки динамики популярности запросов. Он поможет сформировать семантическое ядро или, например, определить тематику блога в соцсетях.
В сервисе вы найдете следующие разделы: «Подписки», «Год в поиске», «Популярные запросы», «Анализ».

Чтобы узнать популярность конкретного запроса, введите его в строке. Поиск также можно сузить, указав следующие данные:
- Страну. Доступны данные как по отдельным странам, так и по всему миру.

- Временной период. Вы можете посмотреть сведения, начиная с 2004 года. Данные доступны за последние 5 лет, 90, 30, 7 дней, за последний день, последние 4 часа и даже за последний час.
Это сервис для оценки поведения пользователей на сайтах. Он позволяет отслеживать активность аудитории в реальном времени, считать конверсии, проводить A/B-тестирования, оценивать эффективность использования маркетинговых инструментов, в том числе анализировать слова, по которым пользователи переходили на сайт из поиска или по объявлениям контекстной рекламы.
Чтобы подключить счетчик, можно вставить скрипт в код сайта, использовать диспетчер тегов Google или плагин для WordPress, указав ID личного кабинета в Analytics.
Mail.ru
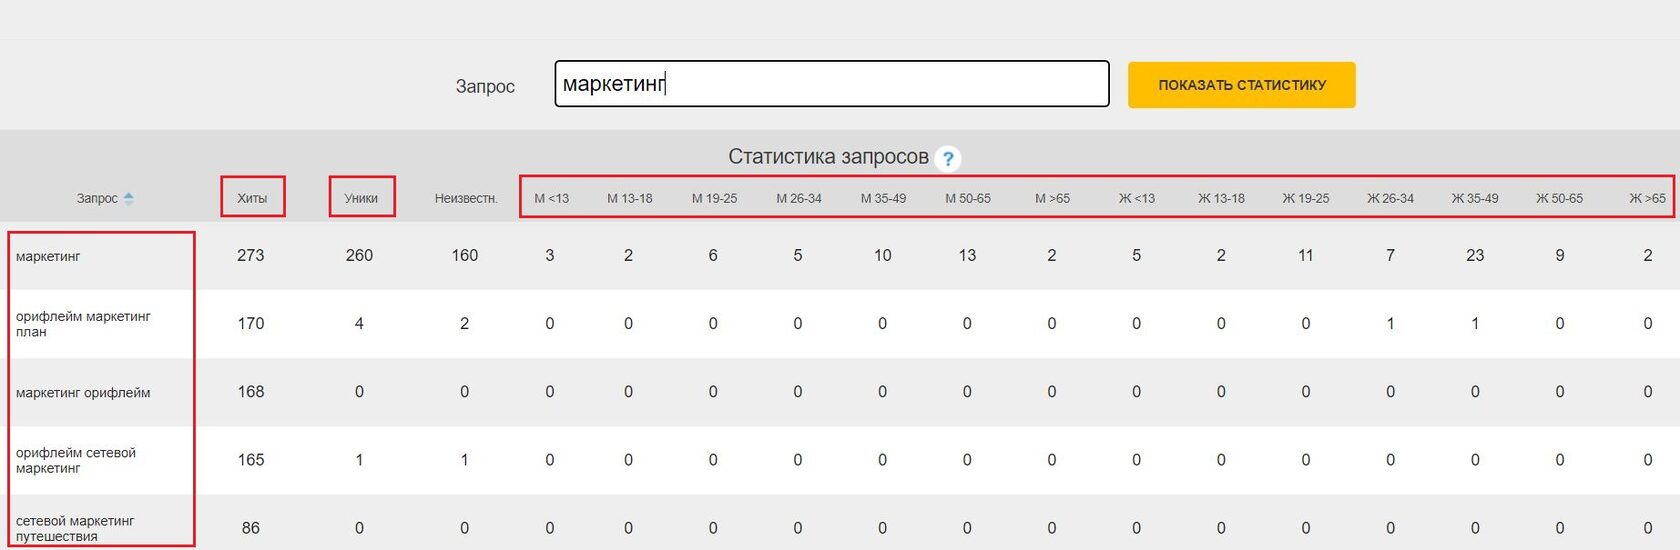
У Mail.ru также есть собственная аналитика. Чтобы изучить фразы, которые пользователи вводят чаще всего, откройте кабинет вебмастера и введите запрос в поисковой строке.

В результате вы увидите таблицу, в которой отражены все возможные фразы, содержащие указанное слово или словосочетание.
В отдельные столбцы вынесены хиты — количество показов по запросу, уники — уникальные пользователи, которым были показаны результаты по ключевой фразе, а также половозрастные категории. В данном случае буква (М или Ж) обозначает пол, рядом указан возрастной диапазон аудитории.
Прочие сервисы
Помимо перечисленных, вы можете использовать сервисы Yahoo, Rambler, Bing. Однако стоит учитывать, что их доля в русскоязычном интернете — около 1%. Это делает результаты нерелевантными.
Также есть множество сторонних, в том числе платных, сервисов, которые отображают статистику по запросам. Например, Key Collector, Ahrefs, Keyword Tool и другие. Подробнее о них расскажем далее.
Хитрости работы с Яндексом и Google — языки поисковых запросов
Ежедневно «Яндекс» обрабатывает 1,5, а Google 3,5–4 млрд запросов. С каждым годом алгоритмы поисковиков все точнее формируют набор ответов на пользовательские запросы, поэтому большинство людей не используют дополнительные инструменты, помогающие добиться от алгоритма более релевантной выдачи. Но пользователи, чья деятельность связана с обработкой большого объема информации, охотно применяют специальный язык поисковых запросов: «Яндекс» и Google предлагают для этого свои наборы инструментов.
Поисковые операторы «Яндекса» и Google: от базовых до продвинутых
Чтобы быстрее находить нужную информацию и получать более точные ответы, научитесь влиять на формирование запросов в поисковых системах с помощью специальных команд. Операторы поисковых запросов — это символы или слова, которые дополнительно вводятся вместе с ключевой фразой. Наличие такой команды — это сигнал для алгоритма, что конкретно он должен искать в своей огромной базе данных.
У «Яндекса» и Google есть базовые операторы, которые известны большинству пользователей, например, кавычки-лапки, которые помогают найти текст по точной цитате, а есть продвинутые символы, о которых знает узкий круг специалистов.
В любом случае, освоив команды, уточняющие поисковые запросы, вы будете быстрее добывать релевантную информацию.
Язык Яндекса: отличия от других поисковых систем и различия внутри сервисов

У разных поисковых систем языки запросов различаются — у каждого свой набор спецсимволов. Конечно это не слишком удобно, но обычно среднестатистический пользователь является приверженцем какого-то одного поисковика, поэтому заучивать несколько наборов у большинства нет необходимости.
У «Яндекса» операторы для уточнения и фильтрации запросов не только отличаются от гугловских, но и различаются внутри экосистемы самого «Яндекса»: в поиске, «Директе» и «Вордстате» не все спецсимволы работают одинаково. В этой статье мы разберем команды для работы с поиском. Про спецсимволы «Вордстата» читайте здесь: «Яндекс Вордстат» ― руководство по подбору ключевых слов.
Что учитывается в запросе по умолчанию
Алгоритмы «Яндекса» учитывают несколько факторов:
- часть речи: существительное, прилагательное, глагол;
- морфологические признаки: падеж, род, число, склонение;
- синонимы.
Это значит, что поисковик выдает все найденные словоформы, образованные от ключевого слова и близкие по смыслу синонимы. При этом однокоренные слова не считаются похожими запросами. Например, «обогреватель» и «обогреть» попадут в одну выдачу, а «грелка» или «нагревать» — нет.
Также алгоритм исправит опечатки, грамматические ошибки и предложит изменить нетипичные слова, которые кажутся ему ошибочными в контексте запроса.
Правила работы «Яндекса»

Составление точного поискового запроса требует соблюдения правил. Чтобы задать алгоритму жесткие рамки, используются специальные команды. Так вы можете исключить из выдачи результаты с синонимами или потребовать у поисковика сохранить порядок слов.
Как составить поисковый запрос в «Яндексе»? Сформулируйте фразу и дополните ее нужной командой:
- В начале фразы вводим ключи.
- Через пробел вводятся нужные команды в виде операторов.
- Если в запросе используется несколько операторов, то каждый вводится через пробел.
ключ оператор№1:значение оператор№2:значение
Любые команды можно комбинировать, чтобы задать более точные условия для фильтрации данных.
Поисковые операторы «Яндекса»
Итак, операторы — это специальные символы и команды, регулирующие параметры поискового запроса. Они помогают очистить результат выдачи от неточных и нерелевантных результатов, конкретизировать поиск.
Виды операторов
Операторы имеют разную форму и делятся на 3 вида:
- Логические — символы и знаки препинания, ставятся рядом со словом, на которое должен распространяться фильтр.
- Документные — команды в виде вспомогательных слов для расширенного поиска, помогают отфильтровать нужные документы по типу, домену или URL-адресу.
- Недокументированные — редкие команды, которые не упоминаются в официальных рекомендациях «Яндекса». Могут работать нестабильно.
Обзор поисковых операторов «Яндекса»
Логические спецзнаки:
- + (плюс)

Маркирует ключ, который должен учитываться алгоритмом. Результаты без отмеченного слова не будут пропущены в выдачу.
Плюс ставится перед ключом без пробела: спряжение +причастий.
Маркер стоп-слов, которые требуется исключить из поиска. Использование оператора минус в поисковом запросе означает, что в выдаче останутся только результаты без отмеченного слова.
Минус ставится перед словом без пробела: купить смартфон -Samsung.
Если необходимо исключить цифры, то их заключают в кавычки, иначе алгоритм воспримет запись как обозначение отрицательного числа.
- “” (кавычки-лапки)

Кавычки фиксируют фразу, которую необходимо найти. Алгоритм учтет количество слов в запросе, но может проигнорировать словоформы. Поисковый запрос в кавычках полезен для определения текста-первоисточника по цитате.
«мы живем под собою не чуя страны»
Если необходимо найти фразу в точном вхождении, перед каждым словом внутри кавычек поставьте восклицательный знак.
- ! (восклицательный знак)
Фиксирует слово в существующей грамматической форме. Алгоритм будет выкидывать из выдачи словоформы в другом падеже, числе и т.д. Используется для поиска фразы в ее точном вхождении. Например: ремонт !на !дому — поисковик не покажет нерелевантные результаты по близкой фразе ремонт дома.

Замена пропущенного слова в цитате. Оператор используется только в комбинации с кавычками. Алгоритм сам подставляет слово вместо звездочки. Такой инструмент полезен при поиске текста по цитате, которую не удалось вспомнить точно: “шумел камыш * гнулись”.
- | (вертикальная черта)
Аналог союза «или». Используется при перечислении нескольких ключей, когда надо найти хотя бы один из списка: работа в типографии резчик | размотчик | оператор.
- [ ] (квадратные скобки)
Фиксируется фраза с учетом порядка слов и всех словоформ: [рок-концерты в спб].
Документные операторы:
Ограничивает поиск доменом и поддоменами одного сайта. Оператор также позволяет навскидку оценить количество проиндексированных страниц web-ресурса.
Например, запрос «правила составления поисковых запросов в яндексе site:web-dius.ru» поможет найти нужную информацию по теме на нашем сайте.
Аналог команды «site:», но поиск ограничивается хостом, без учета поддоменов.

Работает по принципу оператора «host:», но адрес записывается в обратном порядке: например, ключевые фразы rhost:ru.web-dius.www.
Ограничивает поиск определенной страницей или категорией сайта. С помощью этой команды можно также проверить, проиндексирована ли страница.
Например, по запросу «автоподсказки url:https://www.web-dius.ru/blog/poiskovye_podskazki_yandeks/» в поисковике «Яндекс» найдет ключ «автоподсказки» на указанной странице.
Поиск страниц с требуемым ключом в URL. Например: семантика inurl:dius
Ограничивает поиск указанной доменной зоной. Удобно, когда нужна информация по конкретному региону. Например: кризис власти domain:kz.
Поиск страниц, title которых содержит указанное ключевое слово. Например: title:мандариновый сок.

Отфильтровывает документы указанного формата. Оператор понимает расширения doc, ppt, pdf, xls, odp, swf, ods, odt, odg, rtf.
Например, по запросу seo mime:pdf поисковик выдаст все pdf-файлы, где встречается ключ «seo».
Ограничивает поиск информацией на указанном языке. Чтобы определить язык, после двоеточия нужно указать двухбуквенный код: русский — ru, белорусский — be, турецкий — tr, татарский — tt, казахский — kk, английский — en, немецкий — de, французский — fr.
Помогает найти новости за указанный период или найти страницы, которые были обновлены в определенное время. Формулы для ввода периодов или конкретных дат:
- date:ГГГГММДД – конкретная дата;
- date:ГГГГММ* – месяц;
- date:ГГГГ* – год;
- date:ГГГГММДД..ГГГГММДД – период;
- date:>ГГГГММДД – после (или до) указанной даты ( > после, < перед).
Недокументированные операторы:
Фильтрует тематические страницы с обязательным вхождением в текст указанного после оператора слова. Например: типографии спб intext:офсетная печать
Поиск изображений, в названии которых есть указанный ключ.
image: слоненок в яме
Устаревшие знаки в поисковике «Яндекса»

С 2017 года перестали работать следующие типы операторов:
- & — объединение ключей, употребленных в одном предложении;
- && и
- ~ — разделял два ключа, которые не должны были употребляться в одном предложении;
- () — объединяли в группу несколько ключей в запросе;
- !! — фиксировал начальную форму слова.
Сводная таблица действующих операторов «Яндекса»
| Оператор | Предназначение | Синтаксис |
| Логические операторы | ||
| + | Страницы только с маркированным словом | спряжение +причастий |
| — | Удаление из поисковой выдачи страниц с маркированным словом | купить смартфон -Samsung |
| “” | Отбор страниц с совпадением слов во фразе без учета словоформ | «мы живем под собою не чуя страны» |
| ! | Ограничение поиска точной словоформой маркированного ключевика | ремонт !на !дому |
| * | Подстановка пропущенных в ключевой фразе слов. Используется только в комбинации с кавычками | “шумел камыш * гнулись” |
| | | Смысловой аналог союза «или». Используется, когда надо найти хотя бы один ключ из списка | работа в типографии резчик | размотчик | оператор |
| [ ] | Поиск фразы с точным порядком слов | [рок-концерты в спб] |
| Документные операторы | ||
| site: | Поиск в пределах указанного сайта | правила составления поисковых запросов в яндексе site:web-dius.ru |
| host: | Ограничивает поиск зеркалом сайта без поддоменов | ключевые фразы host:www.web-dius.ru |
| rhost: | Выводит в выдачу страницы указанного хоста. Адрес записывается в обратном порядке | ключевые фразы rhost:ru.web-dius.www |
| url: | Ограничение поиска страницей с указанным URL-адресом | автоподсказки url:https://www.web-dius.ru/blog/poiskovye_podskazki_yandeks/ |
| inurl: | Фильтр страниц с указанным словом в URL | семантика inurl:dius |
| domain: | Поиск в указанной доменной зоне | кризис власти domain:kz |
| title: | Фильтр сайтов с ключевым словом в тайтле | title:мандариновый сок |
| mime: | Фильтр документов указанного формата | seo mime:pdf |
| lang: | Поиск документов на указанном языке | Ilon Mask lang:fr |
| date: | Фильтр поиска по дате | рождаемость в России date:2022* |
| Недокументированные операторы | ||
| intext: | Фильтр страниц с обязательным вхождением указанного слова | типографии спб intext:офсетная печать |
| image: | Поиск изображений по ключевому слову в названии | image: слоненок в яме |
Фильтры расширенного поиска
Пользователям не обязательно заучивать все операторы перед тем, как сделать поисковый запрос в «Яндексе» с настройками фильтров. Справа от строки ввода есть специальный инструмент для расширенного поиска. Открыть его можно, нажав на иконку в виде двух горизонтальных ползунков.
Здесь можно настроить фильтры по региону, дате публикации и языку страницы.
Как узнать дату первой индексации страницы в «Яндексе»

Чтобы проверить, когда интересующая вас страница впервые была проиндексирована в поисковике, можно воспользоваться сервисом XML.Яндекс, в котором у вас должны быть лимиты.
- Заходим на https://xml.yandex.ru/test/.
- Вводим URL страницы в поле query.
- Ищем дату первой индексации под тегом >modtime
Поисковые операторы Google
Общие команды обоих сервисов
Язык интернет-запросов поисковых систем частично совпадает. В Google и «Яндексе» одинаково используются логические операторы плюс (+), минус (-), кавычки (“”), звездочка (*), вертикальный слеш (|) и документный оператор «site:».
Базовые операторы Google
Используется для поиска цен в заданной валюте (доллары или евро). Если после оператора поставить цифру, Google будет искать товары по этой цене: смартфон Samsung $ 25.
Оператор, идентичный вертикальному слешу. Его удобнее использовать, потому что проще найти на клавиатуре. Вводится только в верхнем регистре (прописными буквами): купить лещ OR линь OR щука.
Объединяет слова и словосочетания в запросе. В выдачу попадут результаты с объединенными ключами. Оператор вводится только в верхнем регистре: купить лещ AND линь.
Оператор для быстрой конвертации валют или мер измерения: 15 м/с in км/час.
Расширенные

Выводит последнюю копию указанной страницы из кеша Google. Используется для проверки, проиндексированы ли изменения на странице: cache:https://www.web-dius.ru/seo-prodvizhenie/google/
Находит новости и упоминания указанного источника в Google News. Для корректной работы оператора важно переключиться на вкладку «Новости».
картон кама source:rbk
Фильтр по запросам в картографическом сервисе Google Maps.
Поиск видео по ключевому слову.
Прогноз погоды на несколько дней для указанного в запросе места.
Оператор позволяет узнать стоимость акций, ставки и другую информацию по торгам на биржах.
Толковый словарь Google. Находит значение указанного слова по проверенным источникам.
Аналог оператора «Яндекса» mime:. Находит документы с указанным расширением: pdf, doc, xls, ppt, txt, svf, avi, mov. Умеет искать архивы rar, zip и др.
технология офсетной печати filetype:pdf
Комбинация операторов site: и filetype: выявит документы одного формата на указанном сайте.

Поиск вокруг указанного слова. В выдачу попадают страницы, где два ключа находятся на расстоянии (X) слов друг от друга. Например, фразы «как писать» и «поисковые запросы» должны находится на расстоянии не более двух слов друг от друга.
“как писать” AROUND(2) “поисковые запросы”
Ищет страницы со словами из указанной фразы.
allintext:сбор семантического ядра
Поиск страниц с указанным ключом в заголовке Title, допускается нарушение порядка слов. Оператор полезен для анализа сайтов конкурентов.
allintitle:сбор семантического ядра
Поиск страниц с указанным ключом в URL-адресе, аналог оператора «Яндекс» «inurl:».
allinurl:услуги офсетной печати
Работающие частично
Google регулярно удаляет полезные операторы, причем эти изменения не анонсируются, и пользователи порой узнают о них случайно. Некоторые команды работают некорректно, показывая нестабильный результат.
- related: Поиск похожих страниц. Используется для поиска конкурентов.
- #..# Поиск диапазона чисел.
- location: Поиск новостей через Google News в указанной локации.
- loc: Поиск по локации, указанной после двоеточия.
- inanchor: Поиск страниц с анкорами, в которых встречаются указанные ключи.
Сводная таблица поисковых операторов Google
| Оператор | Предназначение | Синтаксис |
| Базовые операторы | ||
| $/€ | Цены в указанной валюте | Смартфон Samsung $ 25 |
| OR | Поиск одного или нескольких ключей из списка | купить лещ OR линь OR щука |
| AND | Объединение ключей в запросе | купить лещ AND линь |
| in | Конвертация величин измерений и валют | 15 м/с in км/час |
| Расширенные | ||
| cache: | Проверка обновления страницы в кэше | cache:https://www.web-dius.ru/seo-prodvizhenie/google/ |
| source: | Новости в Google News по указанной теме и источнику | картон кама source:rbk |
| map: | Поиск по Google Maps | map:леннеберга |
| movie: | Видео по указанной теме | movie:леннеберга |
| weather: | Прогноз погоды в указанной локации | weather:леннеберга |
| stocks: | Информация по торгам на биржах | stocks:газпром |
| define: | Значение слова по авторитетным источникам | define:каландр |
| filetype: | Фильтр для выявления документов указанного формата | технология офсетной печати filetype:pdf |
| AROUND(X) | Поиск текстов с ключами, расположенными друг от друга через указанное количество слов | “как писать” AROUND(2) “поисковые запросы” |
| allintext: | Поиск текстов с указанной фразой | allintext:сбор семантического ядра |
| allintitle: | Поиск заголовков с указанными ключами | allintitle:сбор семантического ядра |
| allinurl: | Поиск страниц с указанными ключами в URL | allinurl:услуги офсетной печати |
Выводы
В этой статье мы подробно разобрали правила и примеры оформления поисковых запросов в «Яндексе» и Google. Специальные команды и символы помогают конкретизировать запрос и добиться от поисковика более точных результатов в выдаче.
Как парсить поисковые запросы в яндексе на python?
@ francisco.friesen Вы можете использовать библиотеку requests и BeautifulSoup для парсинга поисковых запросов.
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42
import requests from bs4 import BeautifulSoup def set_connection(response : str) -> str: """ Функция принимает на вход запрос, который будет парситься Возвращает - html """ session = requests.Session() # Создаем сессию return session.get(f"https://yandex.ru/search/?text=response>&lr=43", headers=< "User-Agent" : "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/99.0.4844.84 Safari/537.36", "Accept" : "*/*" >).text def parse(html : str) -> list[dict]: """ Функция принимает на вход html, который нужно распарсить Возвращает - собранные данные """ with open('index.html', 'w', encoding='utf-8') as file: file.write(html) elements = list() soup = BeautifulSoup(html, 'html.parser') for element in soup.find_all('li', 'class' : ['serp-item', 'desktop-card']>): elements.append(< 'link' : element.find('a', 'target' : '_blank', 'class' : ['Link', 'link', 'organic__url', 'Link_theme_normal']>).get('href'), # Получаем ссылку 'title' : element.find('span', 'class' : ['OrganicTitleContentSpan','organic__title']>).get_text(strip = True) >) return elements if __name__ == '__main__': html = set_connection(response = "dropcode.ru") elements = parse(html = html) # Получаем информацию карточек.
Стоит учитывать — что данный способ не будет работать постоянно без прокси (Yandex быстро будет блокировать запросы)
Так что после 2-3 запроса сайт перестанет отдавать информацию. Единственные выходы — замена прокси и парсинг через эмуляцию действий (selenium)
Что такое парсинг и что о нём обязательно нужно знать маркетологу
Парсинг ускоряет работу в сотни раз. Рассказываем, какие данные можно собирать с помощью него и что об этом говорит закон.

Кадр: фильм «Тёмный рыцарь» / Universal Pictures

Дарья Чепурнова
Обозреватель Skillbox Media, отраслевой журналист. Работала с TexTerra, SMMplanner, «Нетологией», «ПланФактом», Semantica. Написала больше 60 текстов для рекламных кампаний в «Дзене». Вела нишевой канал на YouTube.
Собрать данные с 50 страниц сайта можно за пару часов. Но если этих страниц сотни и тысячи, работа займёт недели. Чтобы ускорить её, можно использовать парсинг.
В этом материале Skillbox Media разберёмся:
- что такое парсинг;
- что можно парсить и зачем это нужно;
- что о парсинге говорит закон;
- как можно парсить данные.
Что такое парсинг
Парсинг — автоматизированный сбор и систематизация информации из открытых источников с помощью скриптов . Другое название этого процесса — веб-скрейпинг.
Скрипты, которые собирают и систематизируют информацию, называются парсерами. Они работают так:
- ищут источники по заданным параметрам — например, парсеру можно дать список сайтов, а он найдёт на них страницы с ценами;
- извлекают из источников нужную информацию — несколько строк текста, ссылку или сумму;
- преобразуют информацию — например, парсер может взять фрагмент из HTML-документа и преобразовать его в текст без кода;
- сохраняют информацию в нужном формате — например, в виде списка или таблицы в Excel.
Парсеры работают на разных языках программирования — Python, JavaScript, PHP 5 и других. Подробнее о принципах работы парсера на JavaScript можно почитать здесь.
Смысл парсинга в том, чтобы ускорить рутинную работу. Чтобы собрать и сохранить в таблице список из тысячи статей на сайте, человек потратит часы. Парсер сделает эту работу за несколько минут. Парсер ускоряет работу в сотни раз и допускает меньше ошибок, чем человек.
Что можно парсить и зачем это нужно
Количество способов использования парсинга бесконечно. С помощью парсинга можно извлекать любую информацию из исходного кода страниц сайтов, из соцсетей, каталогов, файлов и документов.
Мы перечислим самые распространённые способы применения парсинга в маркетинге. Парсерами ищут:
- Цены на товары и услуги. Парсинг сайтов помогает быстро собрать информацию о ценах на продукты конкурентов. Если проводить его регулярно, можно всегда поддерживать конкурентную цену на продукт. Снижать её, когда конкуренты делают скидки, — и повышать, если их цены тоже растут.
- Поисковые фразы. Можно использовать парсинг выдачи «Яндекса», чтобы собрать все возможные ключевые слова. Парсер может сохранять фразы из поисковых подсказок и блока «Люди ищут» внизу.
- Целевую аудиторию в соцсетях. С помощью парсинга собирают людей по нужным критериям — например, тех, кто проявляет активность в сообществах конкурентов. Потом этим людям показывают рекламу. Сейчас очень популярен парсинг во «ВКонтакте», в других соцсетях его используют реже.
- Битые ссылки. Так называют ссылки, ведущие на несуществующую страницу. Парсер может быстро обойти весь сайт и сохранить в документе все битые ссылки — и страницы, на которых они расположены.
- Идеи для контента. Парсер может собрать в одном месте посты или статьи на выбранную тему. Это нужно, чтобы изучить сразу всех конкурентов и выпустить интересный контент. Некоторые парсят сайты, чтобы копировать контент, — например, добывают так описания для тысяч товаров в интернет-магазине.
- Отзывы. Если компания занимается SERM — управлением репутацией в поисковых системах, она может использовать парсеры, чтобы находить новые отзывы. Тогда программы каждый день будут собирать отзывы, появившиеся за последние сутки, а менеджеры быстро отреагируют на них.
Законно ли использовать парсинг
Да, потому что парсинг — просто автоматизация. Парсеры работают с данными, которые можно найти и вручную. А закон не запрещает использовать любые методы сбора общедоступных данных.
Но ограничения всё-таки есть. Парсинг нельзя использовать, чтобы нарушать закон:
- Нагружать парсером сервер сайта так, что он перестаёт работать. Это одна из разновидностей DDoS-атак . За неё могут наказать по статьям 272 или 273 УК РФ штрафом до 200–500 тысяч рублей и лишением свободы на срок до семи лет.
- Использовать полученные данные для спама. Штраф за спам по закону «О рекламе» достигает 500 тысяч рублей за одно сообщение.
- Использовать данные для плагиата . Нарушение авторских прав описано в статье 146 УК РФ. За него могут оштрафовать на сумму до 500 тысяч рублей.
- Распространять личные данные пользователей, полученные в ходе парсинга. Делать это запрещает поправка к закону о персональных данных. За нарушение этого закона предусмотрены штрафы до 18 миллионов рублей для юридических лиц.
Таких преступлений много, а найти виновного сложно. Поэтому наказывают за них редко.
Как можно парсить данные
Есть два способа парсить данные: создать парсер с нуля и использовать готовое решение.
Создание парсера с нуля обычно нужно, если готовые решения не подходят. Например, свои парсеры делают большие интернет-магазины с тысячами товаров, чтобы находить позиции без описания или без важных характеристик.
Поручить создание парсера можно разработчику. А можно сделать его самому, даже если вы не разбираетесь в программировании. В Skillbox проходит бесплатный интенсив, на котором вы сможете создать парсер сайтов на Python за три дня.
Готовые решения подходят, чтобы закрыть типовые задачи. Общедоступных парсеров много. Например:
- TargetHunter собирает целевую аудиторию во «ВКонтакте».
- uXprice мониторит цены конкурентов в интернет-магазинах и рекомендует оптимальные.
- A-Parser — это 90+ парсеров сайтов, поисковых систем и SEO-сервисов. Их можно использовать, чтобы спарсить поисковые фразы или адреса компаний из «Яндекс.Карт».
Главное — в четырёх пунктах
- Парсинг — автоматизированный сбор и систематизация данных. Его проводят с помощью программ, которые называются парсерами. Парсинг нужен, чтобы ускорить рутинную работу.
- Парсить можно что угодно — цены конкурентов, поисковые фразы, аккаунты в соцсетях, битые ссылки.
- Закон не запрещает парсинг. Но его нельзя использовать для преступлений: чтобы распространять личные данные людей, спамить, перегружать сервер сайта.
- Чтобы парсить данные, можно создать парсер с нуля или использовать готовые решения. Последних много — важно найти подходящее для ваших задач.
Материалы Skillbox Media о рекламе и продвижении сайтов
- Что такое уникальность текста, зачем её проверять и как она влияет на SEO
- Руководство по myTarget: как настроить эффективную рекламу во «ВКонтакте» и на других площадках
- Что такое УТП — и как создать сильное предложение, чтобы продавать больше
- Гайд по «Яндекс.Вордстату»: подбираем ключевые слова для SEO, контента и контекстной рекламы
- Как использовать линкбилдинг, чтобы получать хорошие ссылки и не подпасть под санкции
Скрипт — программа, которая последовательно выполняет список однотипных задач.
HTML — язык разметки документов для просмотра веб-страниц в браузере. HTML-документ — файл, в котором всё содержимое страницы размечено кодом.
Так называют подачу большого количества запросов. Сервер не может справиться с ними, и сайт становится недоступен пользователям.
Публикация чужого контента под своим именем. Например, когда компания ворует текст на сайте конкурента и размещает его на своём ресурсе.