Парсер на PHP – это просто
Вебмастеры часто сталкиваются с такой проблемой, когда нужно взять с какого-либо сайта определенную информацию и перенести ее на другой. Можно сначала сохранить информацию на промежуточный носитель, а уже с него загрузить куда-либо, но подобный подход не всегда удобен. В некоторых случаях гораздо быстрее залить парсер на сам сайт, поддерживающий PHP и запустить его удаленно, чтобы он автоматически спарсил информацию и загрузил ее в базу данных ресурса.
Среди уже готовых решений имеются популярные вроде Content Downloader и ZennoPoster, они конечно очень удобны и понятны любому человеку, даже незнакомому с программированием, однако имеют некоторые минусы. К примеру, они платные и не обладают достаточной гибкостью, которую можно вдохнуть в обычный php скрипт. Тем более, что разработка сложного парсера на них нисколько не уступает по времени написанию аналога на php.
Еще есть такая бесплатная вещь как iMacros – скриптовый язык, который может эмулировать действия пользователя в браузере, но тоже не везде такой подход работает лучшим образом.
Многие думают, что программирование, и уж тем более написание парсеров, – очень сложное занятие. На самом деле php – один из самых простых языков, изучить который можно на достаточном уровне за пару недель или месяц.
Парсеры тоже просты в написании, именно поэтому начинающие программисты пишут именно их, чтобы освоить язык.
Первое, что приходит на ум человеку, который решил написать подобный скрипт, — нужно использовать функции для работы со строками (strpos, substr и аналогичные) или регулярные выражения. Это совершенно верно, однако есть один нюанс. Если парсеров нужно будет писать много, то придется разрабатывать свою библиотеку, чтобы не переписывать сто раз одни и те же конструкции, но на это уйдет тонна времени, а учитывая то, что уже существуют аналогичные библиотеки, такое занятие и вовсе оказывается бессмысленным.
Идеальным вариантом для новичка станет изучение библиотеки PHP Simple HTML DOM Parser. Как можно догадаться из названия, она очень проста в освоении. Рассмотрим базовый код:
$html = file_get_html(‘http://www.yandex.ru’);
$a_links = $html->find(‘a’);
Первая строка создает объект страницы, источником которой в данном случае является Яндекс, и записывает в переменную $html, которая имеет несколько функций, например find. Find – ищет элемент по какому-либо параметру, например find (‘a’) – вернет массив всех ссылок страницы. Find(‘#myid’) – вернет массив элементов, id которых равен ‘myid’.
Доступ к параметру href первой попавшейся ссылки осуществляется так:
echo $a_links[ 0 ]->href;
Более подробно можно посмотреть на сайте:
simplehtmldom.sourceforge.net
Библиотека, как уже было сказано выше, очень проста и лучше всего подходит для начинающего программиста, плюс ко всему она работает достаточно быстро и не сильно требовательна к ресурсам сервера.
Есть у этой библиотеки один минус – далеко не все страницы ей оказываются по зубам. Если какой-либо элемент не отображается, но точно известно, что он там есть, лучше воспользоваться библиотекой DOM (Document Object Model). Она хороша во всем, кроме скорости разработки и понятности.
$doc = new DOMDocument();
$doc->loadHTML ( $data );
$searchNodes = $doc->getElementsByTagName( «a» );
echo $searchNodes[ 0 ]->getAttribute( ‘href’ );
Этот скрипт создает сначала объект типа DOM, при этом в переменной $data должен находиться код страницы. Затем находит все теги a (ссылки), с помощью вызова $doc->getElementsByTagName, затем записывает их в массив $searchNodes. Доступ к параметру href первой ссылки на странице осуществляется с помощью вызова $searchNodes[ 0 ]->getAttribute( ‘href’ ).
В итоге скрипт получается более громоздкий, и писать его уже не так удобно, но иногда приходится использовать именно эту библиотеку.
Как я html-парсер на php писал, и что из этого вышло. Вводная часть
Сегодня я хочу рассказать, как написать html парсер, а также с какими проблемами я столкнулся, разрабатывая подобный парсер на php. А проблем было много. И в первой части я расскажу о проектировании парсера, и о возникших проблемах, ведь html парсер отличается от парсера привычных всем языков программирования.
Введение
Я старался написать текст этой статьи максимально понятно, чтобы любой, кто даже не знаком с общим устройством парсеров мог понять то, как работает html парсер.
Здесь и далее в статье я буду называть документ, содержащий html просто «Документ».
Dom дерево, находящееся в элементе, будет называться «Подмассив».
Что должен делать парсер?
Давайте сначала определимся, что должен делать парсер, чтобы в будущем отталкиваться от этого при разработке. А именно, парсер должен:
- Проектировать dom-дерево на основе документа
- Если есть ошибки в документе, то он должен их решать
- Находить элементы в dom-дереве
- Находить children элементы
- Находить текст
Впрочем, это мелочи. Основного функционала вполне хватит, чтобы поломать голову пару ночей напролет.
Но тут есть проблема, с которой я столкнулся сразу же: Html — это не просто язык, это язык гипертекста. У такого языка свой синтаксис, и обычный парсер не подойдет.
Разделяй и властвуй
Для начала, нужно разделить работу парсера на два этапа:
- Отделение обычного текста от тегов
- Сортировка всех полученных тегов в dom дерево
Для описания первого этапа я нарисовал схему, которая наглядно показывает, как обрабатываются данные на первом этапе:
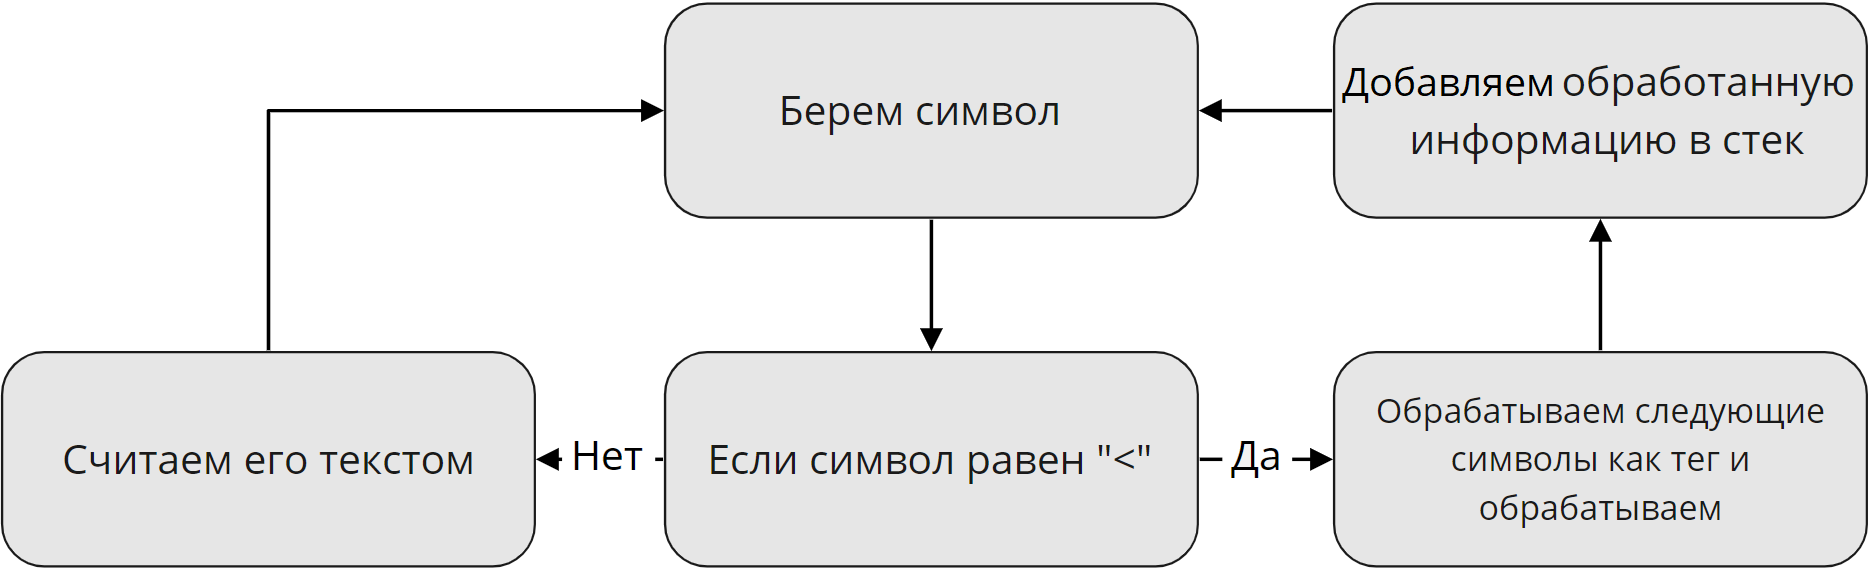
Я решил опустить все мелкие детали. Например, как отличить, что после открывающего »
Также тут стоит уточнить. Логично, что в документе помимо тегов есть еще и текст. Говоря простым языком, если парсер найдет открывающий тег и если в нем будет текст, он запишет его после открывающего тега в виде отдельного тега. Такой тег будет считаться как одиночный и не будет участвовать в дальнейшей работе парсера.
Ну и второй этап. Самый сложный с точки зрения проектирования, и самый простой на первый взгляд с точки зрения понимания:
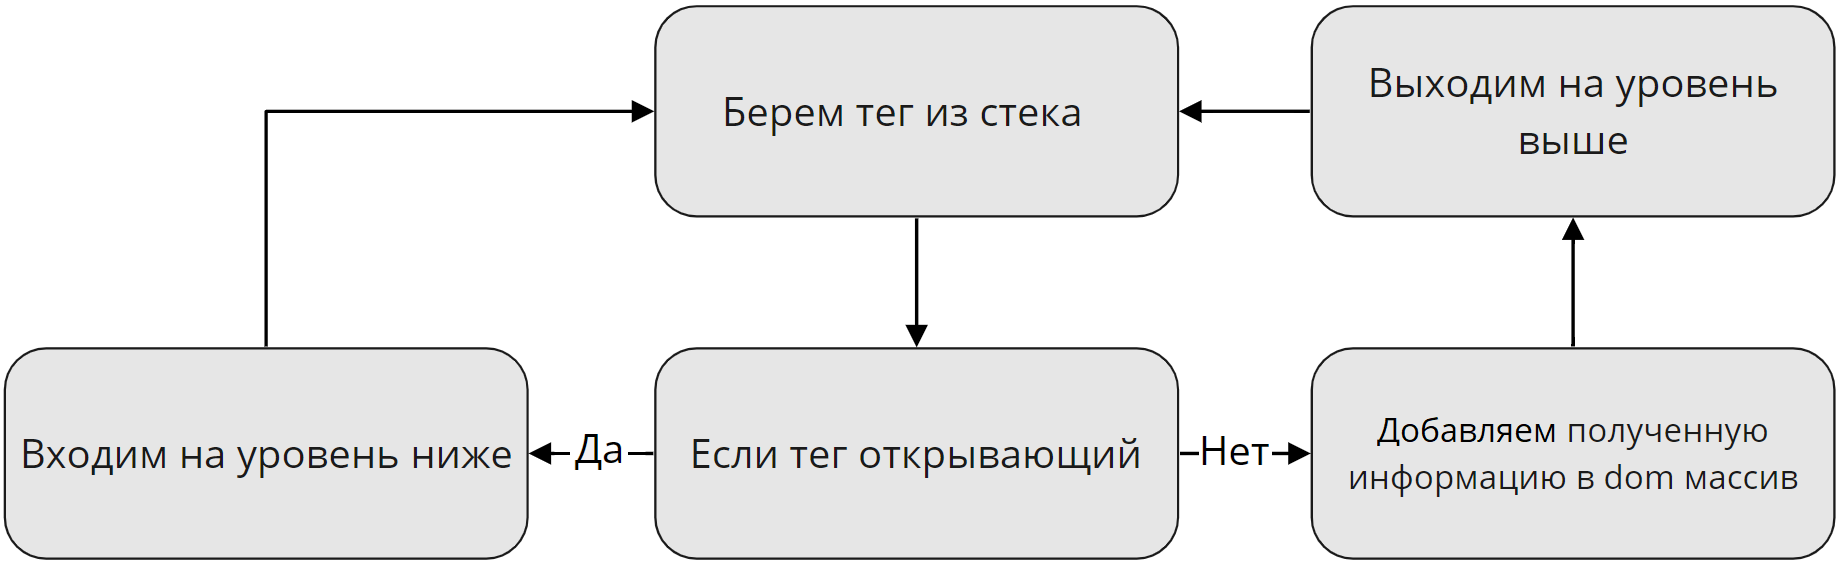
В данном случаи уровень означает уровень рекурсии. То есть если парсер нашел открывающий тег, он вызывает самого себя, «входит на уровень ниже», и так будет продолжаться до тех пор, пока не будет найден закрывающий тег. В этом случаи рекурсия выдает результат, «Выходит на уровень выше». Но, как обстоят дела с одиночными тегами? Такие теги считаются рекурсией ни как открывающие, ни как закрывающие. Они просто переходят в dom «Как есть».
В итоге у нас получится что-то вроде этого:
[0] => Array ( [is_closing] => [is_singleton] => [pointer] => 215 [tag] => div [0] => Array //открывается подмассив ( [0] => Array ( [is_closing] => [is_singleton] => [pointer] => 238 [tag] => div [id] => Array ( [0] => tjojo ) [0] => Array //открывается подмассив ( [0] => Array //Текст записывается в виде отдельного тега ( [tag] => __TEXT [0] => Привет! ) [1] => Array ( [is_closing] => 1 [is_singleton] => [pointer] => 268 [tag] => div ) ) ) ) )
Что там насчет поиска элементов?
А теперь давайте поговорим про поиск элементов. Но тут не все так однозначно, как можно подумать. Сначала стоит разобраться, по каким критериям мы ищем элементы. Тут все просто, мы ищем их по тем же критериям, как это делает Javascript: теги, классы и идентификаторы. Но тут проблема. Дело в том, что тег может быть только один, а вот классов и идентификаторов у одного элемента — множество, либо вообще не быть. Поэтому, поиск элемента по тегу будет отличаться от поиска по классу или идентификатору. Я нарисовал схему поиска по тегу, но не волнуйтесь: поиск по классу или идентификатору не особо отличаются.
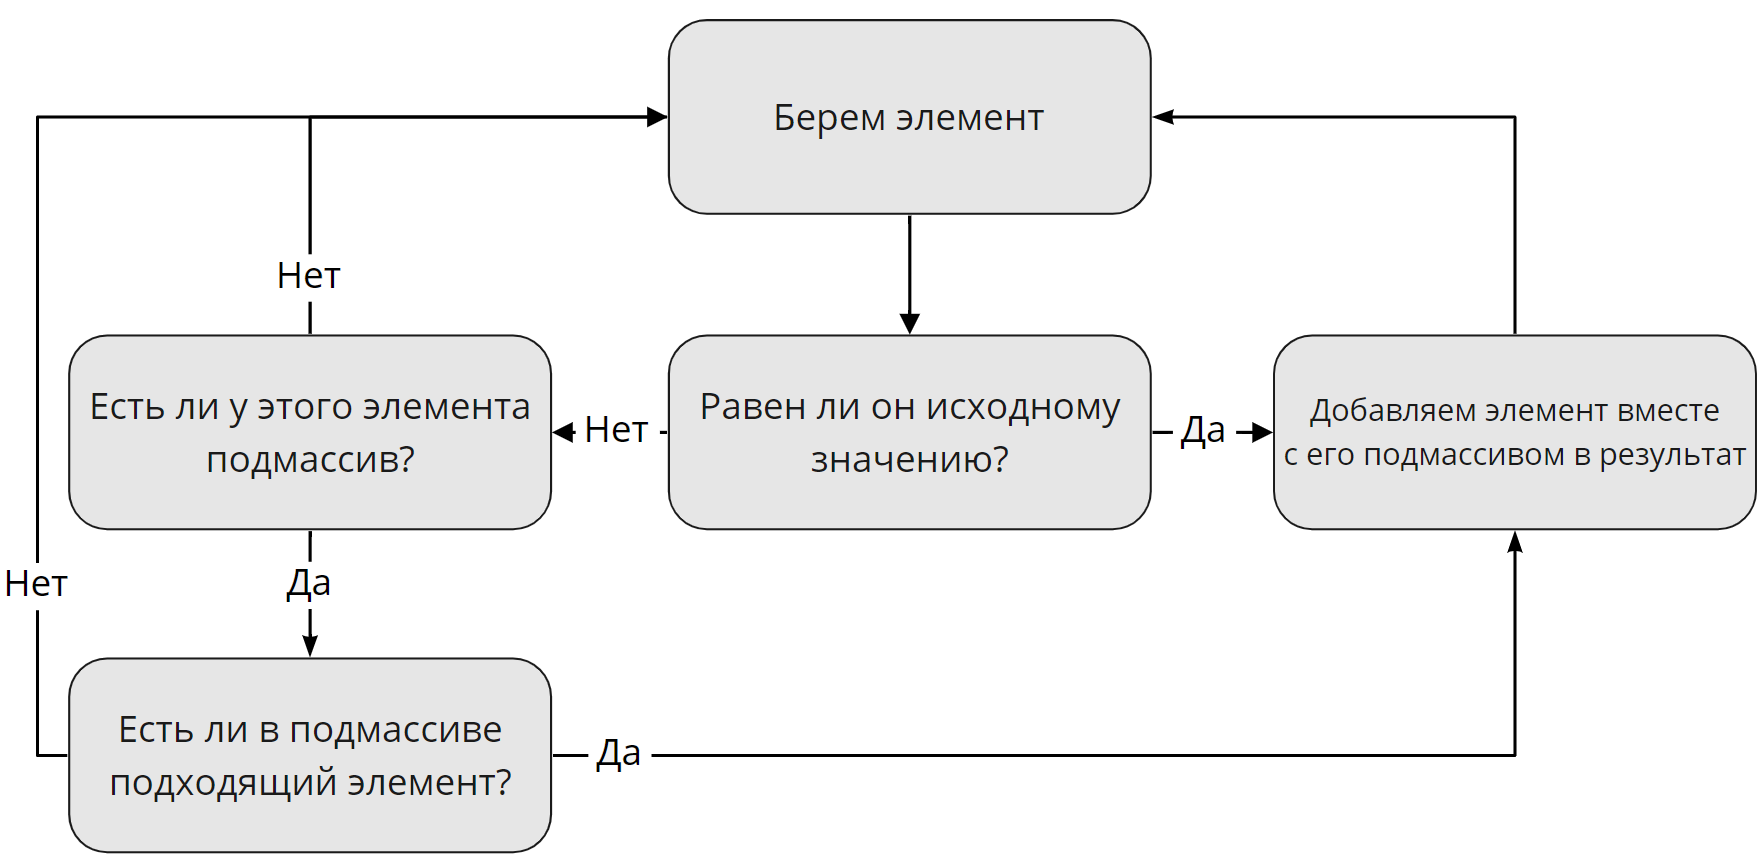
Немного уточнений. Под исходным значением я имел в виду название тега, «div» например. Также, если элемент не равен исходному значению, но у него есть подмассив с подходящим элементом, в результат запишется именно подходящий элемент с его подмассивом, если таковой существует.
Стоит также сказать, что у парсера будет функция, позволяющая искать определенный элемент в документе. Это заметно ускорит производительность парсера, что позволит ему выполняться быстрее. Можно будет, например, взять только первый найденный элемент, или пятый, как вы захотите. Согласитесь, в таком случаи парсеру будет гораздо проще искать элементы.
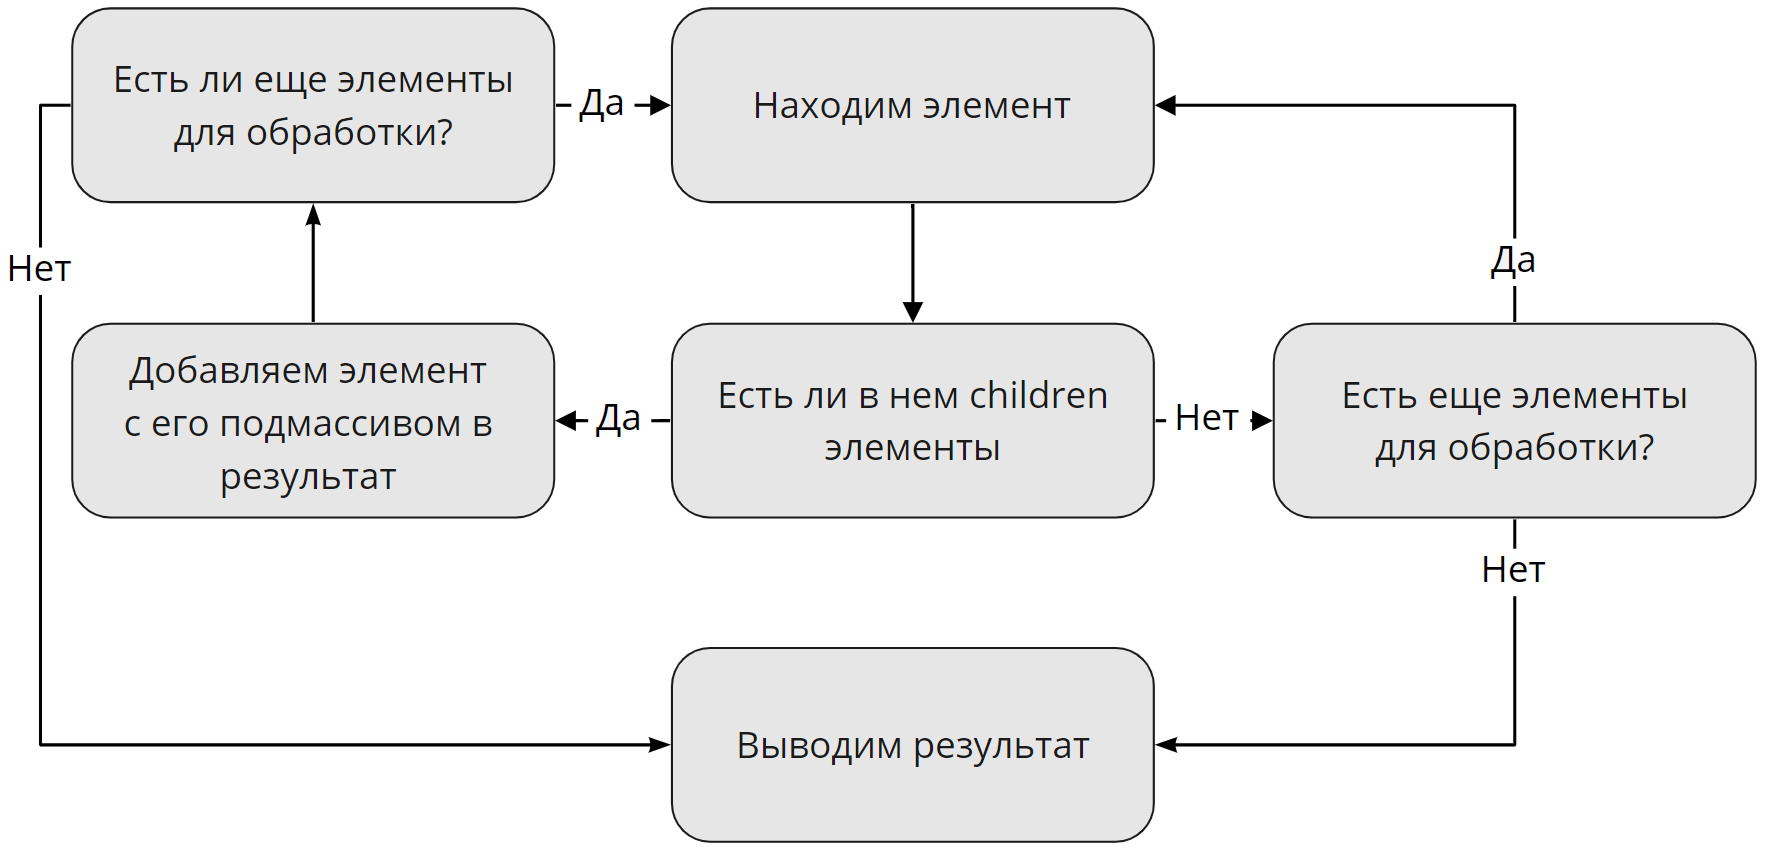
Поиск children элементов
Хорошо, с поиском элементов разобрались, а как насчет children элементов? Тут тоже все просто: наш парсер будет брать все вложенные подмассивы найденных до этого элементов, если таковые существуют. Если таковых нет, парсер выведет пустой результат и пойдет дальше:
Поиск текста
Тут говорить особо не о чем. Парсер просто будет брать весь полученный текст из подмассива и выводить его.
Ошибки
Документ может содержать ошибки, с которыми наш скрипт должен успешно справляться, либо, если ошибка критическая, выводить ее на экран. Тут будет приведен список всех возможных ошибок, о которых, в будущем, мы будем говорить:
- Символ «>» не был найден
Такая ошибка будет возникать в том случаи, если парсер дошел до конца документа и не нашел закрывающего символа «>». - Неизвестное значение атрибута
Данная ошибка сигнализирует о том, что была проведена попытка передачи значения атрибуту когда закрывающий тег был найден.
Script, style и комментарии
В парсере теги script и style будут сразу же пропускаться, поскольку я не вижу смысл их записывать. С комментариями ситуация другая. Если вы захотите из записывать, то вы сможете включить отдельную функцию скрипта, и тогда он будет их записывать. Комментарии будут записываться точно так же как и текст, то есть как отдельный тег.
Заключение
Эту статью скорее нужно считать небольшим экскурсом в тему парсеров html. Я ее написал для тех, кто задумывается над написанием своего парсера, либо для тех, кому просто интересно. Поверьте, это действительно весело!
Данная статья является первой вводной частью. В следующих частях этого цикла уже будет участвовать непосредственно код, и будет меньше картинок с алгоритмами(что прекрасно, потому что рисовать я их не умею). Stay tuned!
Парсинг в PHP: что нужно знать новичкам
Серверная разработка требует от программиста определенного спектра знаний и навыков. Весьма полезным покажется парсер. Главное разобраться, каким образом его реализовать на PHP.
Статья расскажет о том, что такое парсинг, для чего он нужен и как функционирует. В ней будут приведены наглядные примеры, которые пригодятся для любого URL при веб-разработке.
Parsing – это…
Парсер – программное обеспечение, которое осуществляет анализ входных текстовых сведений. После этого занимается извлечением необходимой информации, на основе которых будет производиться результат в заранее заданном формате.
На PHP parser работает так:
- скрипт создает запрос по URL;
- осуществляется получение ответа от сервера в виде HTML или ином текстовом формате;
- сведения анализируются;
- из электронных материалов URL извлекаются (парсятся) нужные элементы;
- формируется и выводится результат.
Итог можно записывать в файлы и базы данных, а также непосредственно выводить на дисплей устройства.
Для чего необходим
При изучении парсеров в PHP стоит выяснить, для чего они вообще нужны. Подобное программное обеспечение:
- Автоматизируют информацию в пределах URL.
- Собирают и обрабатывают большие объемы данных.
- Сравнивают содержимое страниц с заданными параметрами. Пример – поисковые системы.
- Помогают организовывать спам-рассылку.
А еще парсером на PHP можно наполнять собственные веб-ресурсы «чужим» контентом. Подобные проекты стараются блокировать, но это не всегда выходит быстро.
Parser избавляет от перепечатывания информации однотипного характера. Пример – наполнение интернет-магазина тем или иным товаром.
Основа функционирования
Если мы парсим текст, не стоит думать, что парсер будет его читать. Соответствующее ПО:
- получает набор команд и инструкций от разработчика;
- считывает слова;
- сравнивает то, что обнаружено в Сети согласно заданным принципам.
Далее происходит непосредственная обработка. То, как робот ведет себя с информацией командной строки, носит название регулярного выражения. В русском языке также встречается в виде понятий «маски» и «шаблоны».
Для того, чтобы парсер воспринимал регулярные выражения, он должен быть составлен на языке, который поддерживает оные при использовании строк. PHP – один из вариантов, который пользуется спросом.
Регулярные выражения для URL прописываются через синтаксис Unix. Он уже устарел и редко применяется на практике при разработке софта. Но за счет свойств обратной совместимости по сей день Юникс задействован программистами и системными администраторами.
За счет Unix можно регулировать активность parsing. В зависимости от соответствующего значения будет меняться длина строки, копируемой с веб-страницы. Сверхжадный парсинг может считывать весь контент, а также HTML-кодификацию и внешние таблицы CSS.
Почему PHP
PHP – язык программирования, который используется для работы с веб-контентом. Позволяет создавать разнообразный софт: от бизнес-аналитики до игр. Его функции позволяют контактировать с парсерами максимально комфортно:
- Наличие библиотеки libcurl. Она отвечает за подключение скрипта ко всем видам серверов (даже при работе с http протоколами).
- Поддержка регулярных выражений. За их счет парсер осуществляет обработку информации.
- Наличие библиотеки DOM, используемой для работы с XML-расширяемым языком разметки текста. Он пригодится при выводе результатов обработки информации.
- Высокая совместимость с HTML.
При запуске URL сайта и внедрения парсера PHP станет настоящим спасением. Это не слишком сложный, но очень мощный язык.
Parse URL – особенности
Parse_url – функция, которая разбирает URL, а затем осуществляет возврат его компонентов. Применяется в PHP 4, 5, 7.
Стоит запомнить ее следующие особенности:
- mixed parse_url (string $url [int $component = -1]) – функция, которая разбирает URL и возвращает ассоциативный массив со всеми компонентами соответствующего адрес в Сети;
- не позволяет проверять корректность URL;
- разбивает адрес на части.
Parse_url старается разобрать частичные URL предельно корректно.
О параметрах
У рассматриваемой функции есть несколько параметров. Первый – URL.. Это – адрес для разбора. Символы, которые воспринимаются парсером как недопустимые, будут заменяться на подчеркивание.
Component – возможность считывания конкретного элемента адреса в виде строчки. Исключение – php_url_port. Этот вариант предусматривает возврат значения int.
Возвращаемые значения
Если URLs значительно некорректные, парсер может вернуть значение False. Когда component опускается, функция будет возвращать ассоциативный массив. В нем расположен хотя бы один элемент.
В массиве ассоциативного характера (array) могут встречаться такие ключи:
- scheme – пример: http;
- port;
- host;
- pass;
- user;
- query – после знака вопроса;
- fragment – после знака «решетка».
При определении component функция parse_url() вернет строчку или число вместо массива. Когда запрошенный элемент отсутствует в URL, «операция» возвращает значение null (пусто, ничего).
Наглядные примеры – CURL и phpQuery
Если нужно осуществить парсинг сайта, можно использовать для этого библиотеку CURL. Второй вариант – phpQuery, который представлен аналогом jQuery для PHP. Каждый подход имеет собственные преимущества.
Предварительная подготовка
Парсинг на сайте (ru) может быть проведен при помощи функции file_get_content. Помогает получить содержимое необходимой разработчику странички:
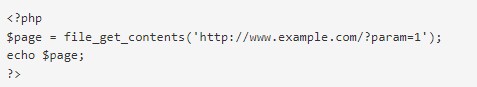
В качестве параметра используется желаемый адрес. Аналогичная функция помогает добавлять заголовки через потоковый контекст:
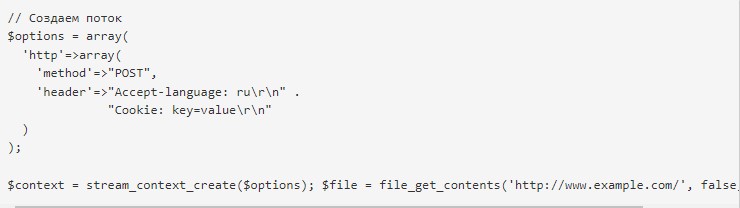
Для запуска соответствующего метода опция allow_url_fopen в php.ini должна быть активирована.
Второй вариант получения содержимого – через сокеты (pfsockopen). Но лучше использовать библиотеку php CURL.
CURL и парсинг
Теперь настало время запуска парсинга. Первый подход – с помощью CURL. Действовать предстоит следующим образом:
- Сначала требуется получить http страницы без параметров.
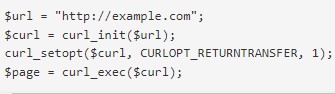
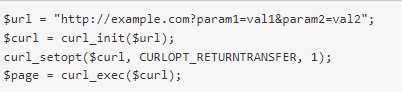
- Получение http странички с get-параметрами.
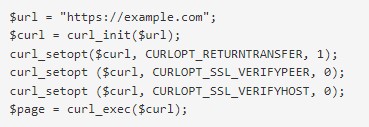
- Получение веб-ресурса по протоколам https.
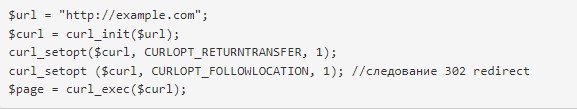
- Извлечение http, которая будет загружаться непосредственно через редиректы (следование 302).
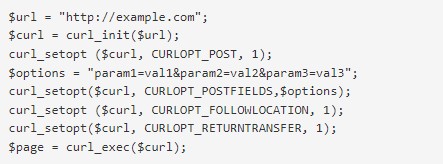
- Нужно сформировать POST-запрос и отправить его. Делаются подобные операции через CURL.
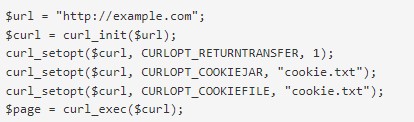
- Требуется активировать куки в запросе.
- В запросе GZIP активировать функцию сжатия. Требуется, когда тело ответа – это непонятный набор текста.

- Вывод заголовков ответов от сервера. Помогает при отладке. Пример – когда сервер не присылает правильное тело ответа или вовсе не дает его.

При парсинге огромную роль играют следующие параметры:
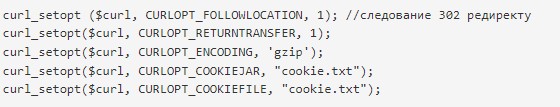
Первый будет всегда в «приложении». Остальные добавляются по мере необходимости. Параметр curlopt_header отвечает за поиск проблем. С ним наладить функционирование парсера php curl не составит никакого труда.
PhpQuery – принцип работы
Второй вариант применения парсинга – через phpQuery. Помогает тогда, когда страничка получена через CURL или иным методом.
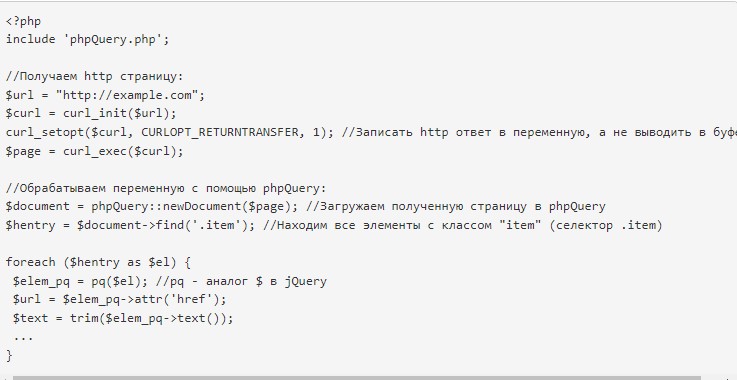
Код выше наглядно показывает, как создать парсер на php через phpQuery. Он выступает полноценным аналогом iQuery. Все функции соответствующей «возможности» прописаны в сопутствующей документации. По этой ссылке можно обнаружить селекторы и методы. А здесь – еще несколько кодов парсеров.
Быстрее освоиться в parsers, а также таких понятиях как print_r, echo, curl и других помогут специализированные дистанционные курсы. В срок от пары месяцев до года удастся освоить программирование «с нуля».
Пишем парсер контента на PHP
Чтобы написать хороший и работоспособный скрипт для парсинга контента нужно потратить немало времени. А подходить к сайту-донору, в большинстве случаев, стоит индивидуально, так как есть масса нюансов, которые могут усложнить решение нашей задачи. Сегодня мы рассмотрим и реализуем скрипт парсера при помощи CURL, а для примера получим категории и товары одного из популярных магазинов.
Если вы попали на эту статью из поиска, то перед вами, наверняка, стоит конкретная задача и вы еще не задумывались над тем, для чего ещё вам может пригодится парсер. Поэтому, перед тем как вдаваться в теорию и непосредственно в код, предлагаю прочесть предыдущею статью – парсер новостей, где был рассмотрен один из простых вариантов, да и я буду периодически ссылаться на неё.
Работать мы будем с CURL, но для начала давайте разберёмся, что эта аббревиатура обозначает. CURL – это программа командной строки, позволяющая нам общаться с серверами используя для этого различные протоколы, в нашем случаи HTTP и HTTPS. Для работы с CURL в PHP есть библиотека libcurl, функции которой мы и будем использовать для отправки запросов и получения ответов от сервера.
Двигаемся дальше и определяемся с нашей целью. Для примера я выбрал наверняка всем известный магазин svyaznoy . Для того, чтобы спарсить категории этого магазина, предлагаю перейти на страницу каталога:

Как можно увидеть из скриншота все категории находятся в ненумерованном списке, а подкатегории:

Внутри отельного элемента списка в таком же ненумерованном. Структура несложная, осталось только её получить. Товары мы возьмем из раздела «Все телефоны»:

На странице получается 24 товара, у каждого мы вытянем: картинку, название, ссылку на товар, характеристики и цену.
Пишем скрипт парсера
Если вы уже прочли предыдущею статью, то из неё можно было подчеркнуть, что процесс и скрипт парсинга сайта состоит из двух частей:
- Нужно получить HTML код страницы, которой нам необходим;
- Разбор полученного кода с сохранением данных и дальнейшей обработки их (как и в первой статье по парсингу мы будем использовать phpQuery, в ней же вы найдете, как установить её через composer).
Для решения первого пункта мы напишем простой класс с одним статическим методом, который будет оберткой над CURL. Так код можно будет использовать в дальнейшем и, если необходимо, модифицировать его. Первое, с чем нам нужно определиться — как будет называться класс и метод и какие будут у него обязательные параметры:
class Parser < public static function getPage($params = [])< if($params)< if(!empty($params["url"]))< $url = $params["url"]; // Остальной код пишем тут >> return false; > >Основной метод, который у нас будет – это getPage() и у него всего один обязательный параметр URL страницы, которой мы будем парсить. Что ещё будет уметь наш замечательный метод, и какие значения мы будем обрабатывать в нем:
- $useragent – нам важно иметь возможность устанавливать заголовок User-Agent, так мы сможем сделать наши обращения к серверу похожими на обращения из браузера;
- $timeout – будет отвечать за время выполнения запроса на сервер;
- $connecttimeout – так же важно указывать время ожидания соединения;
- $head – если нам потребуется проверить только заголовки, которые отдаёт сервер на наш запрос этот параметр нам просто будет необходим;
- $cookie_file – тут всё просто: файл, в который будут записывать куки нашего донора контента и при обращении передаваться;
- $cookie_session – иногда может быть необходимо, запрещать передачу сессионных кук;
- $proxy_ip – параметр говорящий, IP прокси-сервера, мы сегодня спарсим пару страниц, но если необходимо несколько тысяч, то без проксей никак;
- $proxy_port – соответственно порт прокси-сервера;
- $proxy_type – тип прокси CURLPROXY_HTTP, CURLPROXY_SOCKS4, CURLPROXY_SOCKS5, CURLPROXY_SOCKS4A или CURLPROXY_SOCKS5_HOSTNAME;
- $headers – выше мы указали параметр, отвечающий за заголовок User-Agent, но иногда нужно передать помимо его и другие, для это нам потребуется массив заголовков;
- $post – для отправки POST запроса.
Конечно, обрабатываемых значений много и не всё мы будем использовать для нашей сегодняшней задачи, но разобрать их стоит, так как при парсинге больше одной страницы многое выше описанное пригодится. И так добавим их в наш скрипт:
$useragent = !empty($params["useragent"]) ? $params["useragent"] : "Mozilla/5.0 (Windows NT 6.3; W…) Gecko/20100101 Firefox/57.0"; $timeout = !empty($params["timeout"]) ? $params["timeout"] : 5; $connecttimeout = !empty($params["connecttimeout"]) ? $params["connecttimeout"] : 5; $head = !empty($params["head"]) ? $params["head"] : false; $cookie_file = !empty($params["cookie"]["file"]) ? $params["cookie"]["file"] : false; $cookie_session = !empty($params["cookie"]["session"]) ? $params["cookie"]["session"] : false; $proxy_ip = !empty($params["proxy"]["ip"]) ? $params["proxy"]["ip"] : false; $proxy_port = !empty($params["proxy"]["port"]) ? $params["proxy"]["port"] : false; $proxy_type = !empty($params["proxy"]["type"]) ? $params["proxy"]["type"] : false; $headers = !empty($params["headers"]) ? $params["headers"] : false; $post = !empty($params["post"]) ? $params["post"] : false;Как видите, у всех параметров есть значения по умолчанию. Двигаемся дальше и следующей строчкой напишем кусок кода, который будет очищать файл с куками при запросе:
if($cookie_file)< file_put_contents(__DIR__."/".$cookie_file, ""); >Так мы обезопасим себя от ситуации, когда по какой-либо причине не создался файл.
Для работы с CURL нам необходимо вначале инициализировать сеанс, а по завершению работы его закрыть, также при работе важно учесть возможные ошибки, которые наверняка появятся, а при успешном получении ответа вернуть результат, сделаем мы это таким образам:
$ch = curl_init(); curl_setopt($ch, CURLOPT_URL, $url); // Далее продолжаем кодить тут curl_setopt($ch, CURLINFO_HEADER_OUT, true); $content = curl_exec($ch); $info = curl_getinfo($ch); $error = false; if($content === false)< $data = false; $error["message"] = curl_error($ch); $error["code"] = self::$error_codes[ curl_errno($ch) ]; >else < $data["content"] = $content; $data["info"] = $info; >curl_close($ch); return [ "data" => $data, "error" => $error ];Первое, что вы могли заметить – это статическое свойство $error_codes, к которому мы обращаемся, но при этом его ещё не описали. Это массив с расшифровкой кодов функции curl_errno(), давайте его добавим, а потом разберем, что происходит выше.
private static $error_codes = [ "CURLE_UNSUPPORTED_PROTOCOL", "CURLE_FAILED_INIT", // Тут более 60 элементов, в архиве вы найдете весь список "CURLE_FTP_BAD_FILE_LIST", "CURLE_CHUNK_FAILED" ];После того, как мы инициализировали соединения через функцию curl_setopt(), установим несколько параметров для текущего сеанса:
- CURLOPT_URL – первый и обязательный — это адрес, на который мы обращаемся;
- CURLINFO_HEADER_OUT –массив с информацией о текущем соединении.
Используя функцию curl_exec(), мы осуществляем непосредственно запрос при помощи CURL, а результат сохраняем в переменную $content, по умолчанию после успешной отработки результат отобразиться на экране, а в $content упадет true. Отследить попутную информацию при запросе нам поможет функция curl_getinfo(). Также важно, если произойдет ошибка — результат общения будет false, поэтому, ниже по коду мы используем строгое равенство с учетом типов. Осталось рассмотреть ещё две функции это curl_error() – вернёт сообщение об ошибке, и curl_errno() – код ошибки. Результатом работы метода getPage() будет массив, а чтобы его увидеть давайте им воспользуемся, а для теста сделаем запрос на сервис httpbin для получения своего IP.
Кстати очень удобный сервис, позволяющий отладить обращения к серверу. Так как, например, для того что бы узнать свой IP или заголовки отправляемые через CURL, нам бы пришлось бы писать костыль.
$html = Parser::getPage([ "url" => "http://httpbin.org/ip" ]);Если вывести на экран, то у вас должна быть похожая картина:

Если произойдет ошибка, то результат будет выглядеть так:

При успешном запросе мы получаем заполненную ячейку массива data с контентом и информацией о запросе, при ошибке заполняется ячейка error. Из первого скриншота вы могли заметить первую неприятность, о которой я выше писал контент сохранился не в переменную, а отрисовался на странице. Чтобы решить это, нам нужно добавить ещё один параметр сеанса CURLOPT_RETURNTRANSFER.
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);Обращаясь к страницам, мы можем обнаружить, что они осуществляют редирект на другие, чтобы получить конечный результат добавляем:
curl_setopt($ch, CURLOPT_FOLLOWLOCATION, true);Теперь можно увидеть более приятную картину:

Двигаемся далее, мы описали переменные $useragent, $timeout и $connecttimeout. Добавляем их в наш скрипт:
curl_setopt($ch, CURLOPT_USERAGENT, $useragent); curl_setopt($ch, CURLOPT_TIMEOUT, $timeout); curl_setopt($ch, CURLOPT_CONNECTTIMEOUT, $connecttimeout);Для того, чтобы получить заголовки ответа, нам потребуется добавить следующий код:
if($head)
Мы отключили вывод тела документа и включили вывод шапки в результате:

Для работы со ссылками с SSL сертификатом, добавляем:
if(strpos($url, "https") !== false)
Уже получается весьма неплохой скрипт парсера контента, мы добрались до кук и тут стоит отметить — частая проблема, когда они не сохраняются. Одной из основных причин может быть указание относительного пути, поэтому нам стоит это учесть и написать следующие строки:
if($cookie_file) < curl_setopt($ch, CURLOPT_COOKIEJAR, __DIR__."/".$cookie_file); curl_setopt($ch, CURLOPT_COOKIEFILE, __DIR__."/".$cookie_file); if($cookie_session)< curl_setopt($ch, CURLOPT_COOKIESESSION, true); >>Предлагаю проверить, а для этого я попробую вытянуть куки со своего сайта:

Всё получилось, двигаемся дальше и нам осталось добавить в параметры сеанса: прокси, заголовки и возможность отправки запросов POST:
if($proxy_ip && $proxy_port && $proxy_type) < curl_setopt($ch, CURLOPT_PROXY, $proxy_ip.":".$proxy_port); curl_setopt($ch, CURLOPT_PROXYTYPE, $proxy_type); >if($headers) < curl_setopt($ch, CURLOPT_HTTPHEADER, $headers); >if($post)
Это малая доля параметров, с которыми можно работать, все остальные находятся в официальной документации PHP . Вот мы завершили с нашей оберткой, и пришло время, что-нибудь спарсить!
Парсим категории и товары с сайта
Теперь, при помощи нашего класса Parser, мы можем сделать запрос и получить страницу с контентом. Давайте и поступим:
$html = Parser::getPage([ "url" => "https://www.svyaznoy.ru/catalog" ]);Следующим шагом разбираем пришедший ответ и сохраняем название и ссылку категории в результирующий массив:
if(!empty($html["data"]))< $content = $html["data"]["content"]; phpQuery::newDocument($content); $categories = pq(".b-category-menu")->find(".b-category-menu__link"); $tmp = []; foreach($categories as $key => $category) < $category = pq($category); $tmp[$key] = [ "text" =>trim($category->text()), "url" => trim($category->attr("href")) ]; $submenu = $category->next(".b-category-submenu")->find(".b-category-submenu__link"); foreach($submenu as $submen) < $submen = pq($submen); $tmp[$key]["submenu"][] = [ "text" =>trim($submen->text()), "url" => trim($submen->attr("href")) ]; > > phpQuery::unloadDocuments(); >Чуть более подробно работу с phpQuery я разобрал в первой статье по парсингу контента. Если вкратце, то мы пробегаемся по DOM дереву и вытягиваем нужные нам данные, их я решил протримить, чтобы убрать лишние пробелы. А теперь выведем категории на экран:

В результате мы получили все ссылки на категории. Для получения товаров используем тот же принцип:
$html = Parser::getPage([ "url" => "https://www.svyaznoy.ru/catalog/phone/224", "timeout" => 10 ]);Получаем страницу, тут я увеличил время соединения, так как 5 секунд не хватило, и разбираем её, парся необходимый контент:
if(!empty($html["data"]))< $content = $html["data"]["content"]; phpQuery::newDocument($content); $products = pq(".b-listing__generated-container")->find(".b-product-block .b-product-block__content"); $tmp = []; foreach($products as $key => $product) < $product = pq($product); $tmp[] = [ "name" =>trim($product->find(".b-product-block__name")->text()), "image" => trim($product->find(".b-product-block__image img")->attr("data-original")), "price" => trim($product->find(".b-product-block__misc .b-product-block__visible-price")->text()), "url" => trim($product->find(".b-product-block__info .b-product-block__main-link")->attr("href")) ]; $chars = $product->find(".b-product-block__info .b-product-block__tech-chars li"); foreach($chars as $char)< $tmp[$key]["chars"][] = pq($char)->text(); > > phpQuery::unloadDocuments(); >Теперь проверим, что у нас получилось, и выведем на экран:
» target=»_blank» » alt=»» />

Вот мы и написали парсер контента PHP, как видите, нет нечего сложного, при помощи этого скрипта можно легко спарсить страницы любого сайта, но перед тем, как заканчивать статью, хотелось пояснить некоторые моменты. Во-первых, если вы хотите парсить более одной страницы, то не стоит забывать, что сам процесс парсинга ресурса затратная операция, поэтому в идеале лучше, чтобы скрипт был вынесен на отдельный сервер, где и будет запускаться по крону. Ещё один момент — к каждому донору стоит подходить индивидуально, так как, во-первых: у них разный HTML код и он, с течением времени, может меняться, во-вторых: могут быть различные защиты от парсинга и проверки, поэтому для подбора необходимого набора заголовков и параметров может потребоваться отладочный прокси (я пользуюсь Fiddler). И последние, что я добавлю — используйте для парсинга прокси и чем больше, тем лучше, так как, когда на сервер донора полетят тысячи запросов, то неизбежно IP, с которого осуществляется обращение будет забанен, поэтому стоит прогонять свои запросы через прокси-сервера.
Полный пример с библеотекай phpQuery вы найдете на github .