Почему ИИ пишут на питоне, если он медленный? [закрыт]
Закрыт. На этот вопрос невозможно дать объективный ответ. Ответы на него в данный момент не принимаются.
Хотите улучшить этот вопрос? Переформулируйте вопрос так, чтобы на него можно было дать ответ, основанный на фактах и цитатах.
Закрыт 1 месяц назад .
Зачем это делают? Питон это довольно медленный язык
- python
- искусственный-интеллект
Отслеживать
25k 4 4 золотых знака 20 20 серебряных знаков 36 36 бронзовых знаков
задан 12 окт в 8:32
ИИ обучается и выполняется не на питоне, это просто удобное высокоуровневое АПИ, а внутри там обычный C/C++ и код для видеокарт
12 окт в 8:36
Библиотеки машинного обучения используют Си, Фортран даже, и Си++. Обертка в виде Питона позволяет обеспечить удобство работы.
12 окт в 8:41
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
По поводу питона сказано:
Прежде всего, Python — язык с открытым исходным кодом. Это означает, что он доступен для любых модификаций, которые разработчики сочтут нужными. Этот язык программирования постоянно развивается, что упрощает его синтаксис и повышает его эффективность. Во-вторых, существует большое количество готовых к использованию библиотек, которые помогают ускорить написание кода. Например, TensorFlow широко применяется для машинного обучения и работы с наборами данных; scikit — для обучения моделей машинного обучения; PyTorch — для обработки речи и для компьютерного зрения. Это ощутимое преимущество, которое может помочь ускорить разработку и сэкономить ресурсы, поскольку позволяет применять готовые решения вместо их создания с нуля.
Да, Python медленный, но меня это не волнует
Разговоры о снижении производительности ради продуктивности.
Я беру паузу в моём обсуждении asyncio в Python, чтобы поговорить о скорости Python. Позвольте представиться, я — ярый поклонник Python, и использую его везде, где только удаётся. Одна из причин, почему люди выступают против этого языка, — то, что он медленный. Некоторые отказываются даже попробовать на нём поработать лишь из-за того, что «X быстрее». Вот мои мысли на этот счёт.
Производительность более не важна
Раньше программы выполнялись очень долго. Ресурсы процессора и памяти были дорогими, и время работы было важным показателем. А уж сколько платили за электричество! Однако, те времена давно прошли, потому что главное правило гласит:
Оптимизируйте использование своих самых дорогих ресурсов.
Исторически самым дорогим было процессорное время. Именно к этому подводят при изучению информатики, фокусируясь на эффективности различных алгоритмов. Увы, это уже не так — железо сейчас дёшево как никогда, а вслед за ним и время выполнения становится всё дешевле. Самым дорогим же становится время сотрудника, то есть вас. Гораздо важнее решить задачу, нежели ускорить выполнение программы. Повторюсь для тех, кто просто пролистывает статью:
Гораздо важнее решить задачу, нежели ускорить выполнение программы.
Вы можете возразить: «В моей компании заботятся о скорости. Я создаю веб-приложение, в котором все ответы приходят меньше, чем за x миллисекунд» или «от нас уходили клиенты, потому что считали наше приложение слишком медленным». Я не говорю, что скорость работы не важна совсем, я хочу лишь сказать, что она перестала быть самой важной; это уже не самый дорогой ваш ресурс.
Скорость — единственная вещь, которая имеет значение.
Когда вы употребляете слово «скорость» в контексте программирования, скорей всего вы подразумеваете производительность CPU. Но когда ваш CEO употребляет его применительно к программированию, то он подразумевает скорость бизнеса. Самая главная метрика — время выхода на рынок. В конечном счёте неважно насколько быстро работают ваши продукты, не важно на каком языке программирования они написаны или сколько требуется ресурсов для их работы. Единственная вещь, которая заставит вашу компанию выжить или умереть, — это время выхода на рынок. Я говорю больше не о том, насколько быстро идея начнёт приносить доход, а о том, как быстро вы сможете выпустить первую версию продукта. Единственный способ выжить в бизнесе — развиваться быстрее, чем конкуренты. Неважно, сколько у вас идей, если конкуренты реализуют их быстрее. Вы должны быть первыми на рынке, ну или как минимум не отставать. Чуть затормозитесь — и погибните.
Единственный способ выжить в бизнесе — развиваться быстрее, чем конкуренты.
Поговорим о микросервисах

Крупные компании, такие как Amazon, Google или Netflix, понимают важность быстрого развития. Они специально строят свой бизнес так, чтобы быстро вводить инновации. Микросервисы помогают им в этом. Эта статья не имеет никакого отношения к тому, следует ли вам строить на них свою архитектуру, но, по крайней мере, согласитесь с тем, что Amazon и Google должны их использовать. Микросервисы медленны по своей сути. Сама их концепция заключается в том, чтобы использовать сетевые вызовы. Иными словами, вместо вызова функции вы отправляетесь гулять по сети. Что может быть хуже с точки зрения производительности?! Сетевые вызовы очень медленны по сравнению с тактами процессора. Однако, большие компании по-прежнему предпочитают строить архитектуру на основе микросервисов. Я действительно не знаю, что может быть медленнее. Самый большой минус такого подхода — производительность, в то время как плюсом будет время выхода на рынок. Создавая команды вокруг небольших проектов и кодовых баз, компания может проводить итерации и вводить инновации намного быстрее. Мы видим, что даже очень крупные компании заботятся о времени выхода на рынок, а не только стартапы.
Процессор не является вашим узким местом
Если вы пишете сетевое приложение, такое как веб-сервер, скорее всего, процессор не является узким местом вашего приложения. В процессе обработки запроса будет сделано несколько сетевых обращений, например, к базе данных или кешу. Эти сервера могут быть сколь угодно быстрыми, но всё упрётся в скорость передачи данных по сети. Вот действительно классная статья, в которой сравнивается время выполнения каждой операции. В ней автор считает за один такт процессора одну секунду. В таком случае запрос из Калифорнии в Нью-Йорк растянется на 4 года. Вот такая вот сеть медленная. Для примерных расчётов предположим, что передача данных по сети внутри датацентра занимает около 3 мс, что эквивалентно 3 месяцам по нашей шкале отсчёта. Теперь возьмём программу, которая нагружает CPU. Допустим, ей надо 100 000 циклов, чтобы обработать один вызов, это будет эквивалентно 1 дню. Предположим, что мы пишем на языке, который в 5 раз медленнее — это займёт 5 дней. Для тех, кто готов ждать 3 месяца, разница в 4 дня уже не так важна.
В конечном счёте то, что python медленный, уже не имеет значения. Скорость языка (или процессорного времени) почти никогда не является проблемой. Google описал это в своём исследовании. А там, между прочим, говорится о разработке высокопроизводительной системы. В заключении приходят к следующему выводу:
Решение использовать интерпретируемый язык программирования в высокопроизводительных приложениях может быть парадоксальным, но мы столкнулись с тем, что CPU редко когда является сдерживающим фактором; выразительность языка означает, что большинство программ невелики и большую часть времени тратят на ввод-вывод, а не на собственный код. Более того, гибкость интерпретируемой реализации была полезной, как в простоте экспериментов на лингвистическом уровне, так и в предоставлении нам возможности исследовать способы распределения вычислений на многих машинах.
Другими словами:
CPU редко когда является сдерживающим фактором.
Что, если мы всё-таки упираемся в CPU?
Что насчёт таких аргументов: «Всё это прекрасно, но что, если CPU становится узким местом и это начинает сказываться на производительности?» или «Язык x менее требователен к железу, нежели y»? Они тоже имеют место быть, однако вы можете масштабировать приложение горизонтально бесконечно. Просто добавьте серверов, и сервис будет работать быстрее 🙂 Без сомнения, Python более требователен к железу, чем тот же C, но стоимость нового сервера гораздо меньше стоимости вашего времени. То есть дешевле будет докупить ресурсов, а не бросаться каждый раз что-то оптимизировать.
Так что, Python быстрый?
На протяжении всей статьи я твердил, что самое важное — время разработчика. Таким образом, остается открытым вопрос: быстрее ли Python языка X во время разработки? Смешно, но я, Google и кое-кто ещё, могут подтвердить насколько продуктивен Python. Он скрывает так много вещей от вас, помогая сосредоточиться на основной вашей задаче и не отвлекаясь на всякие мелочи. Давайте рассмотрим некоторые примеры из жизни.
По большей части все споры вокруг производительности Python скатываются к сравнению динамической и статической типизации. Думаю, все согласятся, что статически типизированные языки менее продуктивны, но на всякий случай вот хорошая статья, объясняющая почему. Что касается непосредственно Python, то есть хороший отчёт об исследовании, в котором рассматривается, сколько времени потребовалось, чтобы написать код для обработки строк на разных языках.
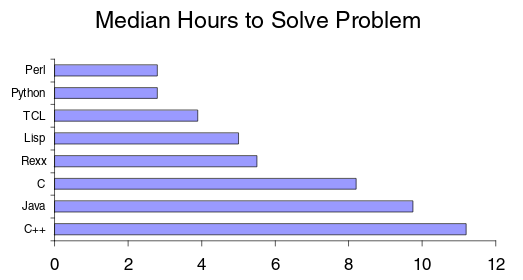
В представленном выше исследовании Python более чем в 2 раза продуктивнее Java. Многие другие также языки программирования дают похожий результат. Rosetta Code провёл довольно обширное исследование различий изучения языков программирования. В статье они сравнивают python с другими интерпретируемыми языками и заявляют:
Python, в целом, наиболее краток, даже в сравнении с функциональными языками (в среднем в 1,2-1,6 раза короче).
По-видимому, в реализации на Python будет как правило меньше строк кода, чем на каком-либо другом языке. Это может показаться ужасной метрикой, однако несколько исследований, в том числе и упомянутых выше, показывают, что время, затраченное на каждую строку кода, примерно одинаково на каждом языке. Таким образом, чем меньше строк кода, тем больше продуктивность. Даже сам codinghorror (программист на C#) написал статью о том, что Python более продуктивен.
Я думаю, будет справедливо сказать, что Python более продуктивен, чем многие другие языки программирования. В основном это связано с тем, что он поставляется «с батарейками», а также имеет множество сторонних библиотек на все случаи жизни. Вот небольшая статья, сравнивающая Python и X. Если вы мне не верите, можете сами убедиться насколько этот язык программирования прост и удобен. Вот ваша первая программа:
import __hello__Но что, если скорость действительно важна?
Мои рассуждения выше могли сложить мнение, что оптимизация и скорость выполнения программы вообще не имеют значения. Во многих случаях это не так. Например, у вас есть веб-приложение и некоторый endpoint, который уж очень тормозит. У вас могут быть даже определённые требования на этот счёт. Наш пример строится на некоторых предположениях:
- есть некоторый endpoint, который выполняется медленно
- есть некоторые метрики, определяющие насколько медленными может быть обработка запросов
Дисклеймер
Должен заметить, что есть некоторые приложения, которые обрабатывают данные в реальном времени, которые нуждаются в микрооптимизации, и каждая миллисекунда имеет значение. Но это скорее исключение, чем правило.
Чтобы понять как оптимизировать, мы должны сначала понять что именно надо оптимизировать. В конце концов:
Любые улучшения, сделанные где-либо помимо узкого места, являются иллюзией. — Джин Ким.
Если оптимизация не устраняет узкого места приложения, то вы просто потратите впустую своё время и не решите реальную проблему. Вы не должны продолжать разработку, пока не исправите тормоза. Если вы пытаетесь оптимизировать нечто, не зная конкретно что, то вряд ли результат вас удовлетворит. Это и называется «преждевременной оптимизацией» — улучшение производительности без каких-либо метрик. Д. Кнуту часто приписывают следующую цитату, хотя он утверждает, что она не его:
Преждевременная оптимизация — корень всех зол.
Если быть точным, то более полная цитата:
Мы должны забыть об эффективности, скажем, на 97% времени: преждевременная оптимизация — корень всех зол. Однако мы не должны упускать наши возможности в этих критических 3%.
Другими словами, здесь говорится, что большую часть времени вам не нужно думать об оптимизации. Код и так хорош 🙂 А в случае, когда это не так, нужно переписать не более 3% Вас никто не похвалит, если вы сделаете обработку запроса на несколько наносекунд быстрее. Оптимизируйте то, что поддаётся измерению.
Преждевременная оптимизация, как правило, заключается в вызове более быстрых методов или использовании специфичных структур данных из-за их внутренней реализации. В университете нас учили, что если два алгоритма имеют одну асимптотику Big-O, то они эквивалентны. Даже если один из них в 2 раза медленнее. Компьютеры сейчас настолько быстры, что вычислительную сложность пора измерять на большом количестве данных. То есть, если у вас есть две функции O(log n), но одна в два раза медленнее другой, то это не имеет большого значения. По мере увеличения размера данных они обе начинают показывать примерно одно и то же время выполнения. Вот почему преждевременная оптимизация — это корень всего зла; Это тратит наше время и практически никогда не помогает нашей общей производительности.
В терминах Big-O все языки программирования имеют сложность O(n), где n — кол-во строк кода или инструкций. Не имеет значения, насколько медленным будет язык или его виртуальная машина — все они имеют общую асимптоту. В соответствии с этим рассуждением можно сказать, что «быстрый» язык программирования всего лишь преждевременно оптимизированный, причём непонятно по каким метрикам.
Оптимизируя Python
Что мне нравится в Python, так это то, что он позволяет оптимизировать небольшой участок кода за раз. Допустим, у вас есть метод на Python, который вы считаете своим узким местом. Вы оптимизировали его несколько раз, возможно, следуя советам отсюда и отсюда, и теперь пришли к выводу, что уже сам Python является узким местом. Но он имеет возможность вызова кода на C, а это означает, что вы можете переписать этот метод на C, чтобы уменьшить проблему с производительностью. Вы без проблем можете использовать этот метод вместе с остальным кодом.
Это позволяет писать хорошо оптимизированные методы узких мест на любом языке, который компилируется в ассемблерный код, то есть вы продолжаете писать на Python большую часть времени и переходите к низкоуровневому программированию лишь вам это действительно нужно.
Существует также язык Cython, который является надмножеством Python. Он представляет из себя смесь с типизированным C. Любой код Python является также валидным кодом и на Cython, который транслируется в C. Вы можете смешивать типы C и утиную типизацию. Используя Cython, вы получаете прирост производительности только в узком месте, не переписывая весь остальной код. Так делает, например, EVE Online. Эта MMoRPG использует только Python и Cython для всего стека, проводя оптимизацию только там, где это требуется. Кроме того, есть и другие способы. Например, PyPy — реализация JIT Python, которая может дать вам значительное ускорение во время выполнения долгоживущих приложений (например, веб-сервера), просто путем замены CPython (реализация по умолчанию) на PyPy.

Итак, основные моменты:
- оптимизируйте использование самого дорогого ресурса — то есть вас, а не компьютера;
- выбирайте язык/фреймворк/архитектуру, которая позволяет вам разрабатывать продукты как можно быстрее. Не стоит выбирать язык программирования лишь потому, что программы на нём работают быстро;
- если у вас проблемы с производительностью — определите, где именно;
- и, скорее всего, это не ресурсы процессора или Python;
- если это всё же Python (и вы уже оптимизировали алгоритм), реализуйте проблемное место на Cython/C;
- и побыстрее возвращайтесь к основной работе.
- python
- сравнение производительности
- продуктивность работы
- почему не любят python
Стоит ли винить Python в низкой производительности?
Признаюсь, что сейчас на работе я занимаюсь разработкой на Python, в связи с чем вы можете счесть мое мнение предвзятым. И все же мне хочется развенчать некоторую критику в отношении Python и прояснить, стоит ли опасаться проблем со скоростью при повседневном использовании этого языка для обработки, исследования и анализа данных.
Реально ли Python слишком медленный?
С моей точки зрения подобные вопросы стоит задавать в рамках определенного контекста или случая применения. Действительно ли Python медленнее справляется с вычислением чисел, чем компилируемые языки вроде C? Да, так и есть. Причем данный факт известен давно, и именно поэтому библиотеки Python, для которых важна скорость, например NumPy, внутренне задействуют C.
Но во всех ли случаях Python медленнее других языков, которые, к слову, сложнее осваивать и использовать. Если рассмотреть бенчмарки производительности многих библиотек Python, оптимизированных под решение конкретной задачи, то по сравнению с компилируемыми языками справляются они вполне достойно. К примеру, взгляните на тест производительности FastAPI: очевидно, что Go, будучи компилируемым языком, оказывается намного быстрее Python. И все же FastAPI превосходит некоторые из библиотек Go при сборке REST API:
Сноска: в приведенный список не включены C++ и Java, которые демонстрируют еще большую производительность.
Аналогичным образом при сравнении Dask (написана на Python) со Spark (написана на Scala) для конвейеров нейровизуализации, работающих с большими данными, авторы сделали такой вывод.
В целом результаты не показывают существенной разницы производительности между этими движками.
По сути, нужно просто поставить вопрос: “Какая именно скорость нас фактически интересует?”. Если вы выполняете задачу ETL, которая запускается всего раз в день, то вас может вообще не волновать, выполнится ли она за 20 или 200 секунд. В таком случае вы можете предпочесть сделать код простым для понимания, упаковывания и обслуживания с учетом того, что вычислительные ресурсы становятся все более доступными по отношению к дорогостоящему времени разработки.
Вам быстрый или практичный код?
С практической точки зрения есть множество вопросов, которые стоит задать при выборе языка программирования для повседневной работы.
Можно ли с его помощью уверенно решать несколько бизнес-задач?
Если вас интересует лишь скорость, тогда не используйте Python и точка. Есть куда более производительные альтернативы для всевозможных случаев применения. Основные преимущества Python лежат в его читаемости, простоте использования и широком спектре решаемых с его помощью задач. Этот язык можно задействовать в качестве связующего компонента для огромного множества различных систем, сервисов и случаев использования.
Легко ли будет найти достаточное число знакомых с ним сотрудников?
Поскольку Python прост в освоении и применении, количество его пользователей постоянно растет. Бизнес-пользователи, которые ранее работали с числами в Excel, теперь могут быстро освоить программирование на Pandas и стать самодостаточными, избавившись от необходимости постоянно полагаться на ИТ-структуру компании. Это, в свою очередь, снизит нагрузку на департаменты ИТ и аналитики. Помимо прочего, таким образом сокращается время разработки и вывода продукта на рынок.
Сегодня гораздо проще найти инженеров знакомых с Python и способных обслуживать Spark-приложение по обработке данных на этом языке, чем тех, кто мог бы проделать то же самое на Java или Scala. Множество организаций постепенно переходят к реализации различных задач с помощью Python, просто потому что гораздо проще найти сотрудников, “говорящих” на этом языке.
В противоположность этому мне известны компании, которые отчаянно нуждаются в Java или C#-разработчиках, которые бы обслуживали существующие приложения. Однако на освоение этих языков уходят годы, в связи с чем они выглядят менее привлекательными для начинающих программистов, которые потенциально могут заработать больше на должностях, где требуется знание менее сложных языков, таких как Go или Python.
Синергия между экспертами из разных областей
Если ваша компания использует Python, то велики шансы, что тот же язык смогут применять бизнес-пользователи, аналитики/инженеры данных, бэкенд и фронтенд-разработчики, инженеры DevOps и даже системные администраторы. Это ведет к эффекту синергии в проектах, где люди из разных областей могут работать сообща и задействовать одни и те же инструменты.
Каковы истинные слабые места в обработке данных?
В своей работе я обычно сталкиваюсь с проблемными местами не в самом языке, а скорее во внешних ресурсах. Для пущей точности я просто приведу ряд примеров.
Запись в реляционные базы данных
При ETL-обработке данных в конечном итоге требуется загружать их в некое централизованное хранилище. И хотя можно задействовать многопоточность Python для ускорения записи данных в реляционную БД, скорее всего это приведет к тому, что увеличение числа параллельных процессов записи превысит ЦПУ-возможности этой базы данных.
На деле я сталкивалась с этим однажды, когда применяла многопоточность для ускорения записи в БД RDS Aurora на AWS. Тогда я заметила, что использование ЦПУ для узла записи настолько возросло, что мне пришлось намеренно замедлить код уменьшением числа потоков, чтобы не нарушить работу экземпляра БД.
Это означает, что в Python есть механизмы для распараллеливания и ускорения многих операций, но реляционная база данных (ограниченная по числу ядер ЦПУ) имеет предел возможностей, который не удастся преодолеть за счет более скоростного языка программирования.
Совершение вызовов к внешним API
Работа с внешними REST API, из которых вам может потребоваться извлечь данные для аналитики, является еще одним примером, где сам по себе язык не оказывается слабым местом. Мы, конечно, можем ускорить извлечение данных, задействовав параллелизм, но иногда это будет напрасным, так как многие внешние API ограничивают количество запросов, которые можно совершать за определенный промежуток времени.
Таким образом, вы зачастую будете оказываться в ситуации, когда приходится намеренно замедлять скрипт, обеспечивая тем самым соответствие установленному для API максимальному числу запросов:
time.sleep(10)
Работа с большими данными
Из своего опыта работы с огромными датасетами могу сказать, что, независимо от используемого языка, загружать действительно “большие данные” в память ноутбука не получится. Для подобных случаев вам скорее понадобится применять фреймворки распределенной обработки, такие как Dask, Spark, Ray и т.д. Существует лимит на количество данных, которые можно обработать при использовании одного экземпляра сервера на ноутбуке.
Если вы хотите распределить фактическую обработку данных на кластер вычислительных узлов, возможно даже задействовав инстансы GPU, которые могут дополнительно ускорить вычисления, то в Python есть обширная экосистема фреймворков, которые эту задачу упростят.
- Хотите ускорить вычисления при обработке данных, задействовав GPU? Используйте Pytorch, Tensorflow, Ray или Rapids (даже с SQL — BlazingSQL).
- Хотите ускорить код Python для обработки больших данных? Используйте Spark (или Databricks), Dask либо Prefect (который внутренне абстрагируется от Dask).
- Хотите ускорить обработку данных при аналитике? Используйте быстрые специализированные резидентные столбчатые базы данных, которые обеспечат высокую скорость обработки при простом использовании SQL-запросов.
Если же вам нужно оркестрировать и отслеживать обработку данных, происходящую в кластере вычислительных узлов, то есть несколько платформ управления рабочим потоком, написанных на Python, которые ускорят разработку и повысят обслуживаемость конвейеров обработки данных. В их число входят Apache Airflow, Perfect и Dagster.
Дополнительно отмечу, что многие, кто жалуются на Python, просто не задействуют все его возможности или применяют для решаемой задачи не самые подходящие структуры данных.
Обобщим. Если вы хотите быстро обрабатывать большие объемы данных, то вам скорее потребуется больше вычислительных ресурсов, чем более скоростной язык программирования. Причем существуют библиотеки Python, которые упрощают процесс распределения работы по сотням узлов.
Заключение
В этой статье мы ответили на вопрос “Действительно ли Python является слабым местом в текущем ландшафте обработки данных?”. Несмотря на то, что он реально медленнее многих компилируемых языков программирования, Python легок в использовании и очень разносторонен. Мы также отметили, что для многих практическая сторона языка берет верх над его производительностью.
В завершении было сказано о том, что как минимум при работе с данными слабым местом скорее явится не сам язык, а внешние системы и большой объем данных, который препятствует их обработке на одной машине, независимо от используемого языка программирования.
- Как установить несколько версий Python в WSL2 и управлять ими
- Thonny — идеальная IDE для новичков Python
- 4 пайтонические техники для краткого кода
Почему python медленный

МЕРОПРИЯТИЯ
YADRO X MOSCOW USER GROUP C++ MEETUP
Комментарии
Популярные По порядку
Не удалось загрузить комментарии.
ЛУЧШИЕ СТАТЬИ ПО ТЕМЕ
ООП на Python: концепции, принципы и примеры реализации
Программирование на Python допускает различные методологии, но в его основе лежит объектный подход, поэтому работать в стиле ООП на Python очень просто.
3 самых важных сферы применения Python: возможности языка
Существует множество областей применения Python, но в некоторых он особенно хорош. Разбираемся, что же можно делать на этом ЯП.
Программирование на Python: от новичка до профессионала
Пошаговая инструкция для всех, кто хочет изучить программирование на Python (или программирование вообще), но не знает, куда сделать первый шаг.