Выбрать данные с минимальной датой из связанной таблицы в MySQL
где account_id — это внешний ключ на столбец id в таблице account . Мне нужно получить для каждого user_id одну запись из таблицы account , которая имеет связанную запись с наименьшей датой created_at в таблице deposit . Я пытался получить данные следующим запросом:
SELECT `account`.`id`, `account`.`user_id`, MIN(`deposit`.`created_at`) AS `date` FROM `account` INNER JOIN `deposit` ON `account`.`id` = `deposit`.`account_id` GROUP BY `account`.`user_id`; Что в итоге я получаю:
+----+---------+---------------------+ | id | user_id | date | +----+---------+---------------------+ | 1 | 2 | 2019-05-30 08:25:56 | | 2 | 12 | 2020-06-16 12:34:04 | | 3 | 13 | 2020-06-22 07:20:57 | +----+---------+---------------------+ Но в первой строке в столбце account.id я ожидаю получить «4«, т.к. именно этот счёт имеет связанную запись с наименьшей датой created_at . Подскажите, пожалуйста, как мне переделать мой запрос, чтобы получить правильный результат.
Заранее спасибо за помощь.
Отслеживать
Haku Kimura
задан 5 июл 2020 в 14:20
Haku Kimura Haku Kimura
1,762 2 2 золотых знака 8 8 серебряных знаков 13 13 бронзовых знаков
Какая версия MySQL?
5 июл 2020 в 16:58
@YitzhakKhabinsky 5.7.
6 июл 2020 в 4:41
как-то так dbfiddle.uk/…, но структура таблиц — ужас
6 июл 2020 в 6:24
@NovitskiyDenis спасибо, ваше решение работает. Оформите ваш sql-запрос, как ответ — я поставлю плюс и отмечу, как принятый. А по поводу структуры, многое делалось до меня, поэтому и приходится изощряться.
6 июл 2020 в 15:23
2 ответа 2
Сортировка: Сброс на вариант по умолчанию
Когда задаете вопрос, необходимо предоставить DDL и образец вставки данных.
Предполагая, что MySQL версии 8.0
-- DDL and sample data population, start CREATE TABLE account (id INT NOT NULL PRIMARY KEY, user_id INT); INSERT INTO account (id, user_id) VALUES (1, 2), (2,12), (3,13), (4, 2), (5, 2), (6, 2); CREATE TABLE deposit (id INT, account_id INT, created_at DATETIME, value DECIMAL(10,2) , INDEX (account_id), FOREIGN KEY (account_id) REFERENCES account (id)); INSERT INTO deposit (id, account_id, created_at, value) VALUES (1, 1,'2020-06-01 15:51:37',50.00), (2, 1,'2020-06-05 13:05:25',20.00), (3, 1,'2020-06-05 13:36:11',20.00), (4, 2,'2020-06-16 12:34:04',70.00), (5, 3,'2020-06-22 07:20:57',50.00), (6, 4,'2020-05-30 08:25:56',30.00); -- DDL and sample data population, end WITH rs AS ( SELECT a.*, b.created_at , ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY b.created_at) AS seq FROM account a INNER JOIN deposit b ON a.id = b.account_id ) SELECT id, user_id, created_at FROM rs WHERE seq = 1; +----+---------+-------------------------+ | id | user_id | created_at | +----+---------+-------------------------+ | 4 | 2 | 2020-05-30 08:25:56.000 | | 2 | 12 | 2020-06-16 12:34:04.000 | | 3 | 13 | 2020-06-22 07:20:57.000 | +----+---------+-------------------------+ set @row_number := 0; set @user_id := 0; SELECT id, user_id, created_at FROM ( SELECT @row_number := CASE WHEN @user_id = user_id THEN @row_number + 1 ELSE 1 END AS seq, @user_id := user_id as user_id, id, created_at FROM (SELECT a.*, b.created_at FROM account AS a INNER JOIN deposit b ON a.id = b.account_id) as c ORDER BY user_id, created_at ASC) as z WHERE seq = 1; Как составить запрос с выборкой по минимальной дате и ещё одному условию?
Есть таблица с именем example. В ней 3 поля: name (TEXT), status (TEXT), date (TIMESTAMP).
Нужно извлечь один «name», у когорого status=’free’ и с минимальной датой.
Вот мой запрос: select name from example where timestamp(date) IN (select timestamp(min(date)) from example) and status = 'free' LIMIT 1;Проблема: запрос работает до тех пор, пока в таблице не появится name с другим статусом (например status=’stop’) и у этого name с другим статусом как раз таки будет самая минимальная дата. В таком случае этот запрос ничего не возвращает. То есть, как я понимаю, в этом случае он отбирает минимальную дату, независимо от значения status, а потом смотрит status, он не free и соответственно ничего не возвращается.

Вот мне нужно, чтобы в выборку попал item1, так как у него минимальная дата и статус free. А запрос в этом случае не возвращает ничего, так как минимальная дата у item5 со статусом stop.
Пробовал ещё вот так:
select name from example where timestamp(date) IN (select timestamp(min(DATE)) and status = 'free' from example) and status = 'free' LIMIT 1;Нужно как-то переписать запрос, чтобы он высчитывал минимальную дату (date) только из строк со статусом free. Если же есть строки с другими статусами, чтобы он их не считал.
- Вопрос задан более двух лет назад
- 1298 просмотров
Как выбрать максимальную дату в sql
Чтобы выбрать максимальную дату в SQL, можно использовать функцию MAX() в сочетании с функцией даты для выбора максимального значения.
Вот пример использования функции MAX() для выбора максимальной даты из столбца date_column таблицы my_table :
SELECT MAX(date_column) AS max_date FROM my_table; Расчёт длины последовательных периодов в SQL
В процессе аудита часто приходится решать нестандартные задачи анализа данных. В этом может помочь язык SQL. Расскажу об одной из таких задач и о том, как я ее решил.
Мне предстояло, на основании информации о статусе клиентов на отчетную дату подсчитать длительность каждого периода, в котором этот признак был равен единице, и пронумеровать даты по порядку в рамках этих периодов.
Таблица с данными имеет следующий вид:
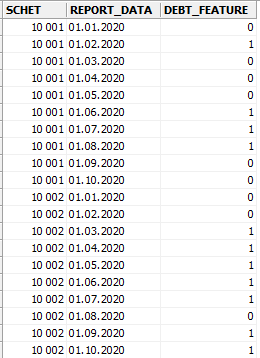
Поля – SCHET (номер счета клиента), REPORT_DATA (отчетная дата – первое число каждого месяца), DEBT_FEATURE (оцениваемый признак на дату отчета).
Я воспользовался оконной функцией row_number() и написал такой запрос:
select new_table.* ,case when debt_feature = 1 then row_number() over(partition by schet, debt_feature order by schet, report_data, debt_feature) else 0 end from new_table order by schet, report_data, debt_feature Получилось не совсем то, что нужно – нумерация была сквозной в рамках каждого счета. Мне же требовалось начинать подсчет заново в рамках каждого периода со статусом «1».
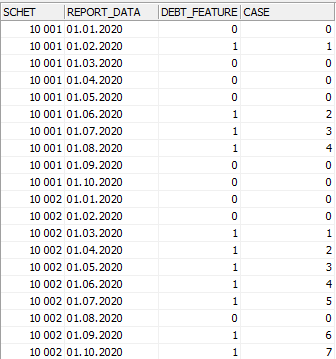
Необходимо добавить какое-то дополнительное поле, чтобы оконная функция корректно разделила таблицу.
Единственным вариантом для манипуляций в данной ситуации является поле, содержащее отчетную дату. Для начала я попробовал найти минимальную и максимальную даты, ограничивающие каждый период в рамках одного счета.
Логика для поиска минимальной даты такая – найти минимальную дату для каждого периода, которая будет больше максимальной даты для предыдущей группы, которая, в свою очередь, должна быть меньше даты в текущей строке. Звучит запутанно, но дальше станет понятнее.
Для нахождения минимальной даты я написал такой запрос:
select nt.* ,( select min(nt_min.report_data) from new_table as nt_min where nt_min.schet = nt.schet and nt_min.debt_feature = nt.debt_feature and nt_min.report_data ( select max(nt_.report_data) from new_table as nt_ where nt_.schet = nt.schet and nt_.debt_feature != nt.debt_feature and nt_.report_data Вот что получилось:
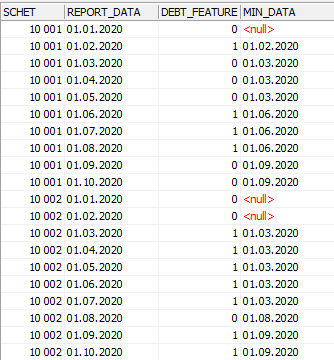
Видно, что для каждого периода, кроме тех, начало которых пришлось на первую запись в рамках счета, найдена минимальная дата. Например, для этой группы:
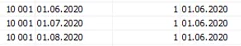
Минимальная дата равна 01.06.2020. Это значение проставляется для каждой записи, принадлежащей выбранной группе.
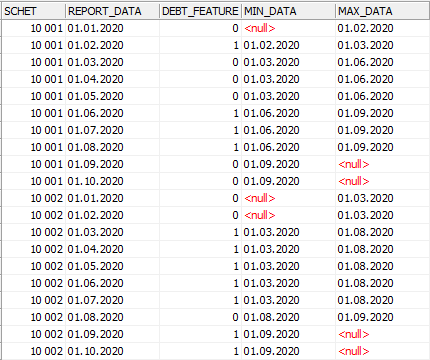
Те записи, с которых начинаются данные в рамках каждого счета не имеют предыдущих периодов. В связи с этим для них минимальная дата не может быть рассчитана – признаку присваивается значение null.
Теперь необходимо найти максимальную дату для каждой группы. Здесь логика проще – найти минимальную дату для следующей группы, большую, чем дата в текущей строке. Запрос получился такой:
select nt.* ,( select min(nt_max.report_data) from new_table as nt_max where nt_max.schet = nt.schet and nt_max.debt_feature != nt.debt_feature and nt_max.report_data > nt.report_data ) as max_data from new_table as nt order by schet, report_data Результат совместного выполнения двух запросов представлен на рисунке:
Посмотрим на тот же период для счета 10001:
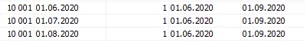
Максимальной дате присвоено значение минимальной даты, следующей за рассматриваемой группой. Также для тех записей, которые не имеют следующей группы, значение признака равно null.
На основании новых данных я рассчитал еще один признак. Для этого посчитал длину каждого периода и объединил ее с датой начала этого периода в виде строки. Также учел случаи, когда минимальная или максимальная дата периода не рассчитана в связи с отсутствием данных (начало или конец периода приходится на начальные или конечные записи в рамках счета). Получилась такая таблица:
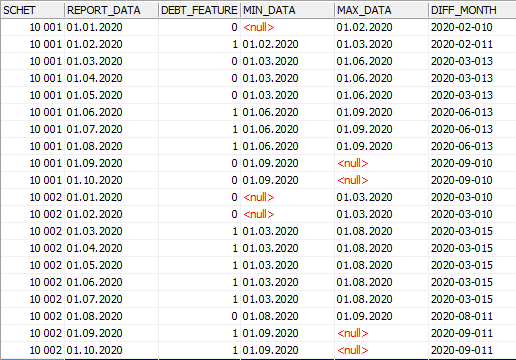
Видно, что новый признак уникален в рамках каждой группы, и можно проводить разбиение данных по нему. Итоговый запрос получился таким:
select result.schet ,result.report_data ,result.debt_feature ,case when result.debt_feature = 1 then result.number else 0 end as count_debt from ( select outer_query.* ,row_number() over(partition by outer_query.schet, outer_query.diff_month order by outer_query.schet, outer_query.report_data) as number from ( select inner_query.* , case when cast(inner_query.min_data as varchar(10)) || cast( (extract(year from inner_query.max_data) * 12 + extract(month from inner_query.max_data)) - (extract(year from inner_query.min_data) * 12 + extract(month from inner_query.min_data)) as varchar(10)) is not null then cast(inner_query.min_data as varchar(10)) || cast( (extract(year from inner_query.max_data) * 12 + extract(month from inner_query.max_data)) - (extract(year from inner_query.min_data) * 12 + extract(month from inner_query.min_data)) as varchar(10)) when inner_query.min_data is not null then cast(inner_query.min_data as varchar(10)) || cast(inner_query.debt_feature as varchar(10)) when inner_query.max_data is not null then cast(inner_query.max_data as varchar(10)) || cast(inner_query.debt_feature as varchar(10)) end as diff_month from ( select nt.* ,( select min(nt_min.report_data) from new_table as nt_min where nt_min.schet = nt.schet and nt_min.debt_feature = nt.debt_feature and nt_min.report_data ( select max(nt_.report_data) from new_table as nt_ where nt_.schet = nt.schet and nt_.debt_feature != nt.debt_feature and nt_.report_data nt.report_data ) as max_data from new_table as nt order by schet, report_data ) as inner_query ) as outer_query order by schet, report_data ) as result В нем я добавил фильтр по признаку, чтобы не выводить подсчет в рамках периодов со значением признака, равным нулю. Также оставил в выводе только столбцы с требуемой информацией без промежуточных расчетов. Результат получился такой, как и требовалось в задаче:
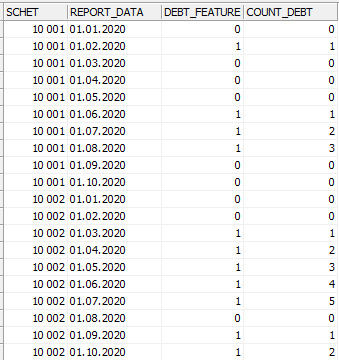
Запрос написан в среде IBExpert для СУБД Firebird 3.0.7.33374_1. При необходимости его можно переработать для любой другой СУБД, поддерживающей оконные функции, например, MS SQL Server.